---
author: "Leonardo Müller"
title: "Relatório de Aula Prática 03 - Análise de Dados"
bibliography: referencias.bib
link-citations: true
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
code-fold: true
code-summary: "Mostrar código"
code-tools: true
execute:
echo: true
warning: false
message: false
---
```{r}
#| include: false
library(tidyverse)
dados <- read_csv2(
"base_processamento_dados_engenharia_civil.csv",
show_col_types = FALSE
)
```
## 📌 Introdução
A utilização de ferramentas computacionais para organização, processamento e análise de dados é uma etapa importante na Engenharia Civil, especialmente em atividades que envolvem grande quantidade de registros de campo, ensaios laboratoriais e informações de controle tecnológico. Antes que esses dados sejam utilizados para análises estatísticas e tomada de decisão, é necessário verificar sua estrutura, identificar possíveis inconsistências e avaliar a qualidade das informações disponíveis.
No ambiente R, a família `tidyverse` reúne pacotes desenvolvidos com uma filosofia comum para importação, transformação, organização e visualização de dados. Entre seus principais recursos estão o `dplyr`, utilizado para manipulação de dados; o `tidyr`, para reorganização das bases; o `stringr`, para tratamento de textos; o `readr`, para importação e conversão de dados; o `purrr`, para aplicação sistemática de funções; e o `ggplot2`, para construção de visualizações [@Wickham2019; @Wickham2023].
Neste relatório, essas ferramentas são aplicadas ao mesmo banco de dados de controle tecnológico do concreto utilizado no Relatório 02. O objetivo é realizar novamente as etapas de inspeção, diagnóstico, limpeza e exploração dos dados, agora priorizando a sintaxe e os fluxos de transformação do `tidyverse`, além de ampliar a análise por meio de recursos de visualização gráfica.
## 🎯 Objetivos
### Objetivo geral
Aplicar ferramentas da família `tidyverse` no processamento, tratamento, transformação, visualização e análise de uma base de dados de controle tecnológico do concreto.
### Objetivos específicos
- Importar e inspecionar a base utilizando funções do `readr`, `dplyr` e `purrr`;
- Identificar valores ausentes, erros de digitação, inconsistências de categorias e valores potencialmente incompatíveis;
- Realizar a limpeza e padronização das variáveis utilizando `dplyr`, `stringr` e `readr`;
- Utilizar fluxos de transformação com o operador `|>`;
- Obter estatísticas descritivas por meio de `group_by()`, `summarise()` e `across()`;
- Criar variáveis derivadas utilizando `mutate()` e `case_when()`;
- Reorganizar e explorar dados com recursos do `tidyr`;
- Produzir gráficos com `ggplot2` para auxiliar a interpretação das propriedades do concreto;
- Avaliar relações entre resistência, idade, dosagem e localização na obra;
- Produzir informações que possam auxiliar a interpretação técnica e a tomada de decisão na Engenharia Civil.
---
## 📚 Fundamentação Teórica
A linguagem R é um ambiente voltado à manipulação, análise estatística e representação de dados. A organização adequada das informações e o conhecimento da estrutura dos objetos são fundamentais para que os resultados obtidos sejam coerentes com o problema analisado [@BatistaOliveira2022].
O `tidyverse` é um conjunto de pacotes que compartilham princípios de projeto, estruturas de dados e formas semelhantes de programação. Essa integração permite construir fluxos de processamento em que diferentes etapas — como importar, selecionar, filtrar, transformar, agrupar, resumir e visualizar — são organizadas de forma sequencial e legível [@Wickham2019]. O operador `|>` favorece esse tipo de construção, permitindo acompanhar a transformação do objeto ao longo das diferentes funções.
Entre as ferramentas utilizadas neste trabalho, o `dplyr` fornece funções como `filter()`, `select()`, `mutate()`, `group_by()` e `summarise()`, enquanto o `stringr` oferece funções específicas para tratamento de textos. O `readr` permite importar e converter valores de forma controlada, e o `ggplot2` utiliza uma estrutura em camadas para representar graficamente distribuições e relações entre variáveis [@Wickham2023].
A estatística descritiva permite organizar e resumir os principais aspectos de uma base por meio de medidas de posição, dispersão e representações gráficas. Entretanto, essas medidas devem ser interpretadas considerando o significado físico das variáveis e a qualidade dos registros utilizados. Dados inconsistentes podem produzir médias, correlações ou gráficos aparentemente válidos, mas tecnicamente inadequados [@Batista2024].
## ⚙️ Metodologia
O trabalho foi desenvolvido utilizando a linguagem R e priorizando funções da família `tidyverse`. Foi analisada uma base de controle tecnológico do concreto composta por 100 observações e 10 variáveis. O arquivo foi importado com `read_csv2()` e mantido sem alterações durante as etapas iniciais de diagnóstico.
Inicialmente, foram avaliadas a estrutura, os tipos das variáveis, os valores ausentes e possíveis inconsistências. Em seguida, foi criada uma cópia denominada `dados_limpos`, utilizada para padronização das categorias e conversão das variáveis quantitativas. As análises posteriores foram realizadas somente após a verificação da base tratada.
As etapas de exploração utilizaram principalmente `filter()`, `select()`, `mutate()`, `group_by()`, `summarise()`, `arrange()`, `count()`, `distinct()` e `across()`. Para tratamento textual foram utilizadas funções do `stringr`, e para visualização foram construídos gráficos com `ggplot2`.
### Etapa 1 – Conhecendo a base
Questões 1 a 6: importação, dimensões da base, estrutura, resumo das variáveis, tipos de dados e investigação sistemática de valores ausentes.
### Etapa 2 – Investigando problemas nos dados
Questões 7 a 11: identificação de valores incompatíveis, possíveis erros de digitação, categorias não padronizadas e avaliação dos tipos das variáveis.
### Etapa 3 – Limpeza e transformação da base
Questões 12 a 16: preservação da base original, padronização textual, conversão das variáveis quantitativas, tratamento dos valores ausentes e verificação da estrutura após a limpeza.
### Etapa 4 – Explorando os dados com `dplyr`
Questões 17 a 20: cálculo da resistência média, comparações entre obras e classes e obtenção de estatísticas agrupadas.
### Etapa 5 – Criando novas variáveis com `mutate()`
Questões 21 a 23: criação das variáveis `resistencia_relativa`, `classificacao` e `acima_media`.
### Etapa 6 – Trabalhando com dados agrupados
Questões 24 a 26: contagem de observações por classe e cálculo simultâneo de diferentes estatísticas de resistência.
### Etapa 7 – Selecionando e reorganizando variáveis
Questões 27 a 30: seleção das propriedades quantitativas, aplicação de `across()`, padronização das variáveis e produção de resumos com múltiplas estatísticas.
### Etapa 8 – Trabalhando com textos e categorias
Questões 31 e 32: padronização textual com `stringr` e utilização de padrões de busca com `str_detect()`.
### Etapa 9 – Visualização dos dados
Questões 33 a 35: construção de gráficos para comparar classes de concreto e investigar as relações entre resistência, consumo de cimento e relação água/cimento.
### Etapa 10 – Aplicações próximas da prática profissional
Questões 36 a 38: avaliação do desempenho dos concretos entre blocos, relação entre idade e resistência e construção de uma tabela-resumo para o engenheiro responsável.
### Desafio Final – O engenheiro responsável pelos dados
Como etapa final, é apresentado um script de inspeção e tratamento priorizando funções do `tidyverse`, organizado de forma que possa ser compreendido e reaproveitado. O procedimento diferencia padronizações que podem ser automatizadas de situações que necessitam de análise técnica posterior e inclui estatísticas descritivas, variáveis derivadas e visualizações.
---
## 🔍 Resultados e Discussão
### Etapa 1 – Conhecendo a base
#### Questão 1 — Importação e visualização inicial
A base foi importada por meio de `read_csv2()` e atribuída ao objeto `dados`. Para verificar a importação, foram utilizadas `slice_head()` e `slice_tail()`, permitindo visualizar as primeiras e as últimas observações sem alterar a base.
```{r}
dados |>
  slice_head(n = 6)
dados |>
  slice_tail(n = 6)
```
A visualização confirma a presença das dez variáveis previstas no enunciado e permite uma primeira conferência dos valores registrados.
#### Questão 2 — Número de observações e variáveis
```{r}
dados |>
  summarise(
    observacoes = n(),
    variaveis = ncol(pick(everything()))
  )
```
A base possui **100 observações e 10 variáveis**. Cada observação representa um corpo de prova ou registro de controle tecnológico, enquanto as colunas armazenam as características associadas a esse registro.
#### Questão 3 — Estrutura da base
```{r}
dados |>
  glimpse()
```
A função `glimpse()` permite visualizar de forma compacta o número de linhas e colunas, os nomes das variáveis, suas classes e alguns valores. Na importação inicial, `idade_dias` é reconhecida como variável quantitativa, enquanto diversas propriedades que deveriam ser numéricas apresentam problemas de interpretação devido às inconsistências de preenchimento existentes na base.
Essa inspeção mostra que a classificação realizada automaticamente pelo R deve ser conferida antes das análises, pois o tipo armazenado nem sempre corresponde ao significado técnico da variável.
#### Questão 4 — Resumo das variáveis
```{r}
dados |>
  map(summary)
```
O resumo inicial chama atenção para diferentes problemas. A variável `idade_dias` apresenta valor máximo de **280 dias**, muito superior às demais idades registradas. Também existem variáveis quantitativas armazenadas como texto, o que impede a obtenção imediata de estatísticas como média, quartis e valores extremos.
Além disso, a inspeção das categorias mostra cinco formas distintas para `tipo_concreto`, embora sejam previstas somente as classes C25, C30, C35 e C40. Esses resultados indicam que a base necessita de diagnóstico e limpeza antes da exploração estatística.
#### Questão 5 — Variáveis quantitativas e qualitativas
```{r}
dados |>
  map_chr(~ class(.x)[1])
```
Na importação inicial, a variável `idade_dias` é reconhecida como quantitativa. `id_corpo_prova`, `obra` e `tipo_concreto` são corretamente interpretadas como variáveis de texto.
Entretanto, `resistencia_mpa`, `cimento_kg_m3`, `relacao_a_c`, `abatimento_mm`, `densidade_kg_m3` e `absorção_agregado_pct` representam grandezas quantitativas e precisam ser convertidas para o tipo numérico após a correção dos problemas de formatação e digitação.
#### Questão 6 — Valores ausentes
```{r}
# Quantidade de valores ausentes por variável
dados |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  )
# Observações que contêm pelo menos um valor ausente
dados |>
  mutate(linha = row_number(), .before = 1) |>
  filter(if_any(everything(), is.na))
```
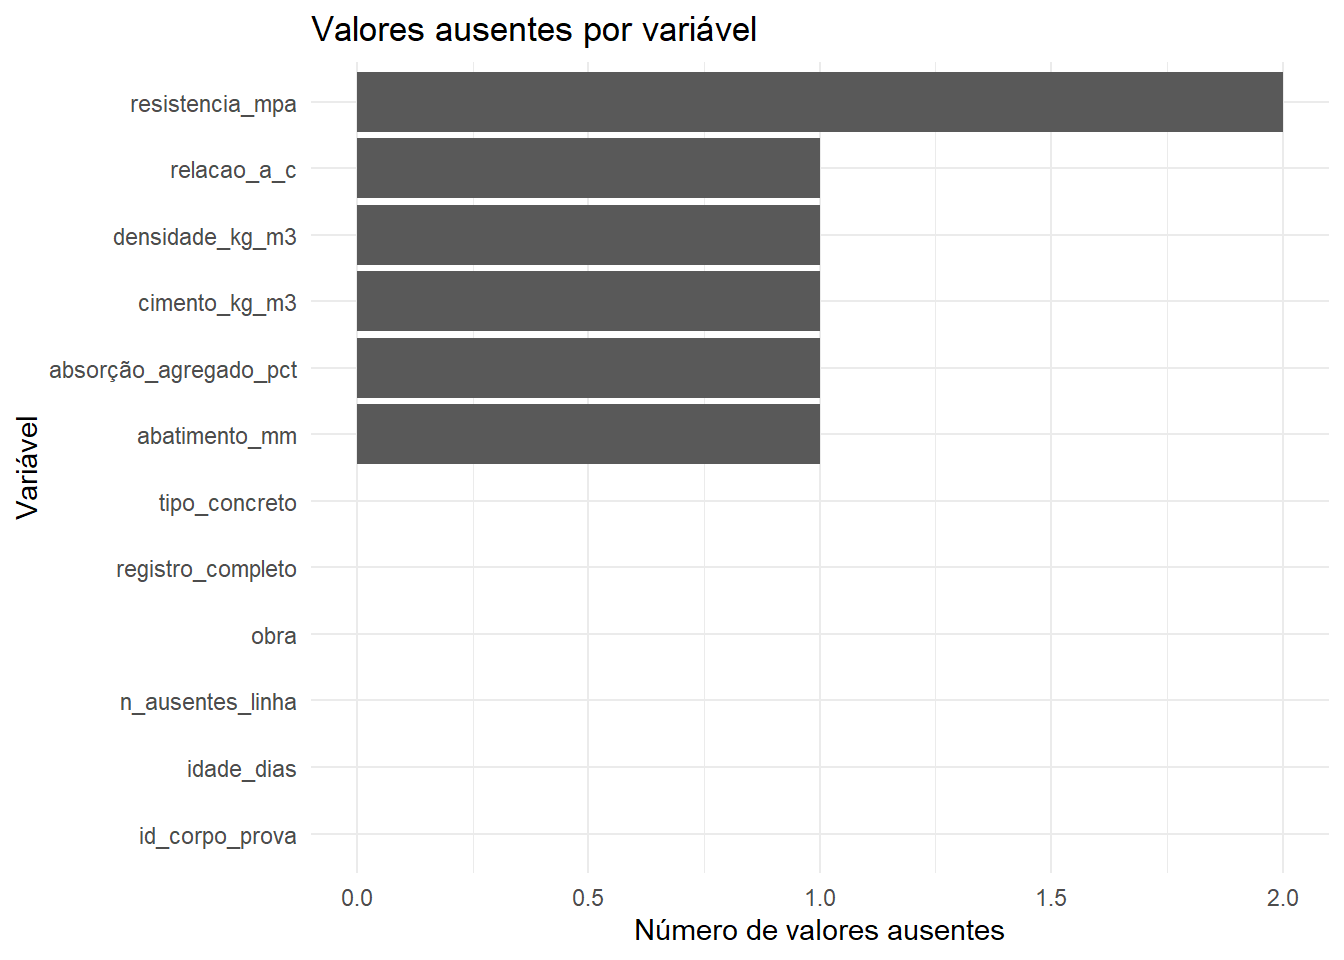
Foram identificados **5 valores ausentes**, distribuídos nas variáveis `resistencia_mpa`, `relacao_a_c`, `abatimento_mm`, `densidade_kg_m3` e `absorção_agregado_pct`, com uma ocorrência em cada variável.
Os valores ausentes correspondem aos corpos de prova **CP-015, CP-038, CP-077, CP-092 e CP-097**. A utilização de `across()` permite realizar a verificação de forma sistemática, sem escrever um comando independente para cada coluna.
### Etapa 2 – Investigando problemas nos dados
#### Questão 7 — Valores potencialmente incompatíveis
Foram utilizados filtros de triagem para localizar registros que apresentam valores ou formatos potencialmente incompatíveis com as variáveis analisadas. Os limites adotados nesta etapa possuem finalidade de **diagnóstico**, não representando limites normativos universais.
```{r}
para_numero <- function(x) {
  x |>
    as.character() |>
    str_replace_all(",", ".") |>
    parse_double(na = c("", "NA"))
}

# Idades potencialmente incompatíveis
dados |>
  filter(idade_dias > 56)
# Resistência: valores que não podem ser interpretados numericamente
dados |>
  filter(
    is.na(para_numero(resistencia_mpa)) &
      !is.na(resistencia_mpa)
  )
# Consumo de cimento: valores que não podem ser interpretados numericamente
dados |>
  filter(
    is.na(para_numero(cimento_kg_m3)) &
      !is.na(cimento_kg_m3)
  )
# Abatimentos com ordem de grandeza muito elevada
dados |>
  filter(para_numero(abatimento_mm) > 300)
# Densidades muito baixas
dados |>
  filter(para_numero(densidade_kg_m3) < 1500)
# Relação água/cimento fora de uma faixa ampla de triagem
dados |>
  filter(
    para_numero(relacao_a_c) < 0.30 |
      para_numero(relacao_a_c) > 0.80
  )
# Absorções muito elevadas
dados |>
  filter(para_numero(`absorção_agregado_pct`) > 10)
```
A investigação localiza a idade de **280 dias**, o abatimento de **1250 mm**, a densidade de **238 kg/m³**, a absorção de **18,4%** e registros que não podem ser convertidos diretamente para números. Esses valores devem ser analisados antes da etapa de limpeza.
#### Questão 8 — Possíveis erros de digitação
```{r}
dados |>
  filter(
    str_detect(as.character(resistencia_mpa), "[A-Za-z]|,") |
      str_detect(as.character(cimento_kg_m3), "[A-Za-z]|,") |
      str_detect(as.character(relacao_a_c), ",")
  ) |>
  select(everything())
```
Foram identificadas quatro observações com problemas claros de digitação ou padronização numérica. O **CP-019** apresenta `3O,4` em `resistencia_mpa`, e o **CP-064** apresenta `390O` em `cimento_kg_m3`, com a letra `O` em registros que deveriam ser numéricos. Os registros **CP-008** e **CP-045** apresentam valores com vírgula decimal (`38,7` e `0,55`) em uma base em que a maior parte das casas decimais foi registrada com ponto.
A combinação de `filter()`, `str_detect()` e `select()` permite localizar esses registros sem alterar os dados originais.
#### Questão 9 — Padronização da variável `obra`
```{r}
dados |>
  distinct(obra)
dados |>
  count(obra, sort = TRUE)
```
A variável `obra` apresenta as categorias `Bloco A`, `Bloco B`, `Bloco C`, `Bloco D` e um registro `Bloco B ` com espaço adicional no final. Embora os dois textos representem o mesmo bloco, eles são tratados como valores diferentes pelo R. A categoria deverá ser padronizada na etapa de limpeza.
#### Questão 10 — Padronização de `tipo_concreto`
```{r}
dados |>
  distinct(tipo_concreto)
dados |>
  count(tipo_concreto, sort = TRUE)
```
Foram identificadas as categorias C25, C30, C35, C40 e `c30`. A categoria `c30` representa a mesma classe de concreto que `C30`, diferenciando-se apenas pelo uso de letra minúscula. Portanto, a variável não está completamente padronizada.
#### Questão 11 — Tipos das variáveis após o diagnóstico
```{r}
dados |>
  glimpse()
dados |>
  map_chr(~ class(.x)[1])
```
Os tipos permanecem os mesmos porque, até este momento, a base original ainda não foi modificada. As inconsistências identificadas explicam por que variáveis quantitativas podem ser armazenadas como texto.
Uma coluna precisa possuir uma representação compatível para todos os seus elementos. Quando registros apresentam letras indevidas, separadores decimais diferentes ou outras formatações incompatíveis, a importação pode deixar de interpretar a coluna de forma homogênea como numérica. Dessa forma, um número digitado incorretamente pode alterar a forma como toda a variável é armazenada.
### Etapa 3 – Limpeza e transformação da base
#### Questão 12 — Preservação da base original
```{r}
dados_limpos <- dados
```
Foi criada uma cópia denominada `dados_limpos`. Preservar `dados` é importante para manter os registros brutos disponíveis para consulta, permitir a comparação entre antes e depois da limpeza e possibilitar a revisão de alguma transformação caso seja necessário.
#### Questão 13 — Padronização das variáveis qualitativas
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    obra = obra |>
      str_trim() |>
      str_squish() |>
      str_to_title(),
    tipo_concreto = tipo_concreto |>
      str_trim() |>
      str_to_upper()
  )

dados_limpos |>
  count(obra)
dados_limpos |>
  count(tipo_concreto)
```
A variável `obra` foi padronizada pela remoção de espaços adicionais e uniformização da escrita. Em `tipo_concreto`, as letras foram convertidas para maiúsculas. Após o tratamento, a base apresenta quatro blocos e quatro classes de concreto: C25, C30, C35 e C40.
Essa abordagem é mais geral do que corrigir somente um registro específico, pois a mesma transformação é aplicada de forma consistente a todas as observações.
#### Questão 14 — Conversão das variáveis quantitativas
As correções abaixo são aplicadas aos problemas diagnosticados nas etapas anteriores. Em uma situação profissional, a fonte original dos dados deve ser consultada sempre que houver dúvida sobre o valor correto.
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    idade_dias = if_else(
      idade_dias == 280,
      28,
      as.numeric(idade_dias)
    ),

    resistencia_mpa = resistencia_mpa |>
      as.character() |>
      str_replace_all(",", ".") |>
      str_replace(fixed("3O.4"), "30.4") |>
      parse_double(),

    cimento_kg_m3 = cimento_kg_m3 |>
      as.character() |>
      str_replace(fixed("390O"), "390") |>
      parse_double(),

    relacao_a_c = relacao_a_c |>
      as.character() |>
      str_replace_all(",", ".") |>
      parse_double(),

    abatimento_mm = abatimento_mm |>
      as.character() |>
      str_replace(fixed("1250.0"), "125.0") |>
      parse_double(),

    densidade_kg_m3 = densidade_kg_m3 |>
      as.character() |>
      str_replace(fixed("238.0"), "2380.0") |>
      parse_double(),

    `absorção_agregado_pct` = `absorção_agregado_pct` |>
      as.character() |>
      str_replace(fixed("18.4"), "1.84") |>
      parse_double()
  )

dados_limpos |>
  glimpse()
```
Após a conversão, resistência, consumo de cimento, relação água/cimento, abatimento, densidade e absorção passam a ser variáveis numéricas. A correção permite realizar cálculos estatísticos de forma adequada.
#### Questão 15 — Tratamento dos valores ausentes
```{r}
dados_limpos |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  )
dados_limpos |>
  filter(if_any(everything(), is.na))
```
Após a limpeza, permanecem **cinco valores ausentes**, referentes aos corpos de prova CP-015, CP-038, CP-077, CP-092 e CP-097.
A **exclusão completa dessas observações não é adequada**, pois cada linha apresenta apenas uma informação ausente e contém diversas outras informações válidas. Eliminar a observação inteira causaria perda desnecessária de dados.
Da mesma forma, **não é adequado substituir automaticamente esses valores pela média**. Embora a imputação pela média possa ser útil em outros tipos de dados e situações, variáveis como resistência à compressão, relação água/cimento e propriedades do concreto representam características específicas de cada registro. A substituição pela média poderia atribuir um valor que nunca foi medido, reduzir artificialmente a variabilidade e interferir nas análises posteriores.
Assim, o procedimento mais adequado é **consultar inicialmente a fonte original dos dados**. Caso a informação não possa ser recuperada, o valor deve permanecer como `NA` e ser tratado de forma explícita nas análises.
#### Questão 16 — Verificação após a limpeza
```{r}
dados_limpos |>
  glimpse()
dados_limpos |>
  summary()
```
Após a limpeza, as variáveis quantitativas passam a ser reconhecidas corretamente como numéricas. As categorias de `obra` e `tipo_concreto` ficam padronizadas, os cinco campos ausentes são representados como `NA` e os valores incompatíveis identificados anteriormente são corrigidos.
O resumo passa a apresentar estatísticas coerentes para as propriedades quantitativas: idade máxima de 56 dias, abatimento máximo de 175 mm, densidade mínima de 2293 kg/m³ e absorção máxima de 2,92%. Dessa forma, a base está em condições mais adequadas para as etapas de exploração.
### Etapa 4 – Explorando os dados com `dplyr`
#### Questão 17 — Resistência média
```{r}
# Resistência média geral
dados_limpos |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE)
  )
# Resistência média por bloco
dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )
# Resistência média por tipo de concreto
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )
# Resistência média por idade
dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )
# Análise complementar: classe + idade
dados_limpos |>
  group_by(tipo_concreto, idade_dias) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto, idade_dias)
```
A resistência média geral foi de aproximadamente **33,55 MPa**. Entre as obras, o Bloco B apresentou a maior média, com **35,70 MPa**, enquanto Blocos C e D apresentaram as menores médias, próximas de 32,4 MPa.
As médias por classe foram **27,07 MPa para C25, 32,08 MPa para C30, 37,10 MPa para C35 e 43,33 MPa para C40**, demonstrando crescimento progressivo conforme a classe.
A média geral por idade aumenta de 28,78 MPa aos 7 dias para cerca de 34,7 MPa aos 14 e 28 dias, mas cai para 33,12 MPa aos 56 dias. Essa última comparação não deve ser interpretada isoladamente, pois mistura diferentes classes. Quando classe e idade são analisadas em conjunto, C30 e C35 apresentam tendência mais clara de crescimento da resistência com a idade.
#### Questão 18 — Comparação entre obras
```{r}
dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))
```
O **Bloco B** apresentou a maior resistência média, com aproximadamente **35,70 MPa**. O **Bloco C** apresentou a menor média, com aproximadamente **32,37 MPa**, valor muito próximo ao Bloco D, com 32,39 MPa.
A utilização de `arrange(desc())` permite organizar diretamente os resultados da maior para a menor média.
#### Questão 19 — Resistência por tipo de concreto
```{r}
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))
```
A classe C40 apresentou a maior resistência média, com **43,33 MPa**, seguida por C35 (37,10 MPa), C30 (32,08 MPa) e C25 (27,07 MPa). O resultado apresenta uma progressão coerente entre a classe do concreto e a resistência média observada.
#### Questão 20 — Estatísticas por grupo
```{r}
variaveis_propriedades <- c(
  "resistencia_mpa",
  "cimento_kg_m3",
  "relacao_a_c",
  "abatimento_mm",
  "densidade_kg_m3"
)

dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    across(
      all_of(variaveis_propriedades),
      ~ mean(.x, na.rm = TRUE)
    ),
    .groups = "drop"
  )
```
A resistência média cresce de **27,07 MPa no C25 para 43,33 MPa no C40**. O consumo médio de cimento também aumenta, passando de aproximadamente **322,52 para 404,13 kg/m³**, enquanto a relação água/cimento diminui de aproximadamente **0,620 para 0,478**.
O abatimento médio reduz gradualmente entre as classes, de aproximadamente 115,17 mm no C25 para 104,94 mm no C40. A densidade apresenta variação comparativamente pequena, permanecendo próxima de 2360 a 2383 kg/m³.
Nesta abordagem, `summarise(across())` calcula cada média utilizando os valores disponíveis na respectiva variável. Isso evita que a ausência em uma propriedade elimine desnecessariamente o mesmo registro do cálculo das demais propriedades.
### Etapa 5 – Criando novas variáveis com `mutate()`
#### Questão 21 — Resistência relativa
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    resistencia_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),
    resistencia_relativa =
      resistencia_mpa / resistencia_referencia
  )

dados_limpos |>
  select(
    id_corpo_prova,
    tipo_concreto,
    resistencia_mpa,
    resistencia_referencia,
    resistencia_relativa
  ) |>
  slice_head(n = 10)
```
A resistência de referência foi associada à própria denominação das classes: 25 MPa para C25, 30 MPa para C30, 35 MPa para C35 e 40 MPa para C40. A variável `resistencia_relativa` representa a razão entre a resistência medida e essa referência.
Valores superiores a 1 indicam resistência observada acima da referência adotada, enquanto valores inferiores a 1 indicam resultado abaixo dela. Essa variável possui finalidade descritiva e comparativa, não substituindo critérios normativos de aceitação do concreto.
#### Questão 22 — Classificação dos corpos de prova
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    classificacao = case_when(
      is.na(resistencia_relativa) ~ NA_character_,
      resistencia_relativa < 1 ~ "Abaixo da referência",
      resistencia_relativa < 1.10 ~ "Atende à referência",
      TRUE ~ "Acima da referência"
    )
  )

dados_limpos |>
  count(classificacao, .drop = FALSE)
```
Foram adotados três grupos descritivos: valores inferiores a 1 foram classificados como **Abaixo da referência**; valores entre 1 e 1,10 como **Atende à referência**; e valores iguais ou superiores a 1,10 como **Acima da referência**.
A base apresenta **24 corpos de prova abaixo da referência, 33 atendendo à referência e 42 acima da referência**, além de uma observação sem classificação devido à ausência de resistência.
O limite de 1,10 foi utilizado apenas para diferenciar resultados próximos da referência daqueles claramente superiores dentro desta análise exploratória.
#### Questão 23 — Resistência acima da média da classe
```{r}
dados_limpos <- dados_limpos |>
  group_by(tipo_concreto) |>
  mutate(
    acima_media =
      resistencia_mpa > mean(resistencia_mpa, na.rm = TRUE)
  ) |>
  ungroup()

dados_limpos |>
  count(acima_media, .drop = FALSE)
```
A variável `acima_media` é criada diretamente dentro de cada grupo de `tipo_concreto`, sem a necessidade de calcular manualmente as quatro médias. Foram identificados **49 registros acima da média de sua classe, 50 iguais ou abaixo e 1 valor ausente**.
Essa solução demonstra uma das vantagens de `group_by()` associado a `mutate()`: a transformação é realizada considerando automaticamente o grupo ao qual cada observação pertence.
### Etapa 6 – Trabalhando com dados agrupados
#### Questão 24 — Número de observações por classe
```{r}
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n_observacoes = n(),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)
```
Foram identificadas **29 observações C25, 32 C30, 23 C35 e 16 C40**, totalizando as 100 observações da base.
#### Questão 25 — Resistência média por classe
```{r}
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))
```
A ordenação reproduz a progressão já observada: C40 apresenta a maior média (43,33 MPa), seguida por C35 (37,10 MPa), C30 (32,08 MPa) e C25 (27,07 MPa).
#### Questão 26 — Múltiplas estatísticas de resistência
```{r}
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    minimo = min(resistencia_mpa, na.rm = TRUE),
    maximo = max(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )
```
A tabela permite avaliar simultaneamente tendência central, dispersão e extremos. Por exemplo, as médias aumentam com a classe, mas os desvios-padrão permanecem em torno de 3 a 3,7 MPa. O C25 apresenta mínimo de 19 MPa, enquanto o C40 alcança máximo de 47,5 MPa.
Apresentar apenas a média poderia ocultar diferenças de dispersão ou resultados individuais muito baixos. Por isso, a combinação entre média, mediana, desvio-padrão, mínimo e máximo fornece uma interpretação mais completa do comportamento das classes.
### Etapa 7 – Selecionando e reorganizando variáveis
#### Questão 27 — Seleção das propriedades quantitativas
A variável `idade_dias` é quantitativa, mas representa a idade de ensaio e não uma propriedade física do concreto. Por esse motivo, ela não foi incluída no conjunto de propriedades selecionado.
```{r}
variaveis_propriedades <- c(
  "resistencia_mpa",
  "cimento_kg_m3",
  "relacao_a_c",
  "abatimento_mm",
  "densidade_kg_m3",
  "absorção_agregado_pct"
)

dados_quantitativos <- dados_limpos |>
  select(all_of(variaveis_propriedades))

dados_quantitativos |>
  slice_head(n = 10)
```
A seleção reúne resistência, consumo de cimento, relação água/cimento, abatimento, densidade e absorção do agregado, mantendo fora da análise variáveis que possuem outra função no banco de dados.
#### Questão 28 — Médias com `across()`
```{r}
# Uma única operação com across()
dados_quantitativos |>
  summarise(
    across(
      everything(),
      ~ mean(.x, na.rm = TRUE)
    )
  )
# Forma individual para comparação
dados_quantitativos |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    cimento_medio = mean(cimento_kg_m3, na.rm = TRUE),
    relacao_ac_media = mean(relacao_a_c, na.rm = TRUE),
    abatimento_medio = mean(abatimento_mm, na.rm = TRUE),
    densidade_media = mean(densidade_kg_m3, na.rm = TRUE),
    absorcao_media = mean(`absorção_agregado_pct`, na.rm = TRUE)
  )
```
As duas abordagens produzem os mesmos resultados: resistência média de aproximadamente **33,55 MPa**, consumo de cimento de **357,62 kg/m³**, relação a/c de **0,554**, abatimento de **110,33 mm**, densidade de **2373,10 kg/m³** e absorção de **1,79%**.
Quando existem muitas variáveis, `across()` apresenta maior facilidade de manutenção, pois a mesma função é aplicada a um conjunto de colunas sem repetir a estrutura do comando para cada variável.
#### Questão 29 — Transformação simultânea com `mutate()` e `across()`
Foi escolhida a **padronização estatística (escore z)** das propriedades quantitativas. Essa transformação centraliza cada variável em torno de zero e a expressa em unidades de desvio-padrão, permitindo comparar variáveis originalmente medidas em escalas muito diferentes.
```{r}
dados_padronizados <- dados_limpos |>
  mutate(
    across(
      all_of(variaveis_propriedades),
      ~ (.x - mean(.x, na.rm = TRUE)) /
        sd(.x, na.rm = TRUE),
      .names = "{.col}_z"
    )
  )

dados_padronizados |>
  select(
    id_corpo_prova,
    ends_with("_z")
  ) |>
  slice_head(n = 10)
```
A transformação é útil para análises exploratórias em que se deseja comparar magnitudes relativas entre variáveis. Entretanto, os valores padronizados **não devem substituir as grandezas originais nas interpretações de engenharia**, pois perdem as unidades físicas como MPa, mm e kg/m³.
#### Questão 30 — Múltiplas estatísticas com `across()`
```{r}
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    across(
      all_of(variaveis_propriedades),
      list(
        media = ~ mean(.x, na.rm = TRUE),
        dp = ~ sd(.x, na.rm = TRUE)
      ),
      .names = "{.col}_{.fn}"
    ),
    .groups = "drop"
  )
```
A função `across()` permite aplicar simultaneamente média e desvio-padrão a todas as propriedades selecionadas e organizar os resultados em uma única tabela.
Em comparação com vários comandos separados, essa abordagem reduz repetição, facilita alterações futuras na lista de variáveis e diminui a possibilidade de inconsistências entre cálculos realizados com estruturas diferentes.
### Etapa 8 – Trabalhando com textos e categorias
#### Questão 31 — Padronização da variável `obra`
```{r}
# Antes
dados |>
  count(obra, sort = TRUE)
# Padronização
comparacao_obra <- dados |>
  transmute(
    obra_original = obra,
    obra_padronizada = obra |>
      str_trim() |>
      str_squish() |>
      str_to_title()
  )

# Depois
comparacao_obra |>
  distinct(
    obra_original,
    obra_padronizada
  )
comparacao_obra |>
  count(obra_padronizada)
```
Antes da padronização existiam `Bloco B` e `Bloco B ` como categorias distintas. Após a aplicação das funções do `stringr`, os espaços excedentes são removidos e a base passa a apresentar somente quatro blocos.
A transformação também uniformiza o uso de maiúsculas e minúsculas, tornando o procedimento aplicável de forma consistente a todos os registros.
#### Questão 32 — Busca por padrões com `str_detect()`
Foi utilizado o padrão `^C3`, que identifica textos iniciados por `C3`. Na base padronizada, isso seleciona as classes C30 e C35.
```{r}
dados_limpos |>
  filter(
    str_detect(
      tipo_concreto,
      "^C3"
    )
  ) |>
  select(
    id_corpo_prova,
    obra,
    tipo_concreto,
    resistencia_mpa
  ) |>
  slice_head(n = 20)
```
A utilização de padrões textuais permite localizar grupos de registros mesmo quando não se deseja enumerar cada categoria individualmente. Esse recurso é útil para diagnóstico de grafias, prefixos, códigos, identificadores e padrões suspeitos em bases maiores.
### Etapa 9 – Visualização dos dados
#### Questão 33 — Distribuição da resistência por classe
```{r}
ggplot(
  dados_limpos,
  aes(
    x = tipo_concreto,
    y = resistencia_mpa
  )
) +
  geom_boxplot() +
  labs(
    title = "Distribuição da resistência por tipo de concreto",
    x = "Tipo de concreto",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
```
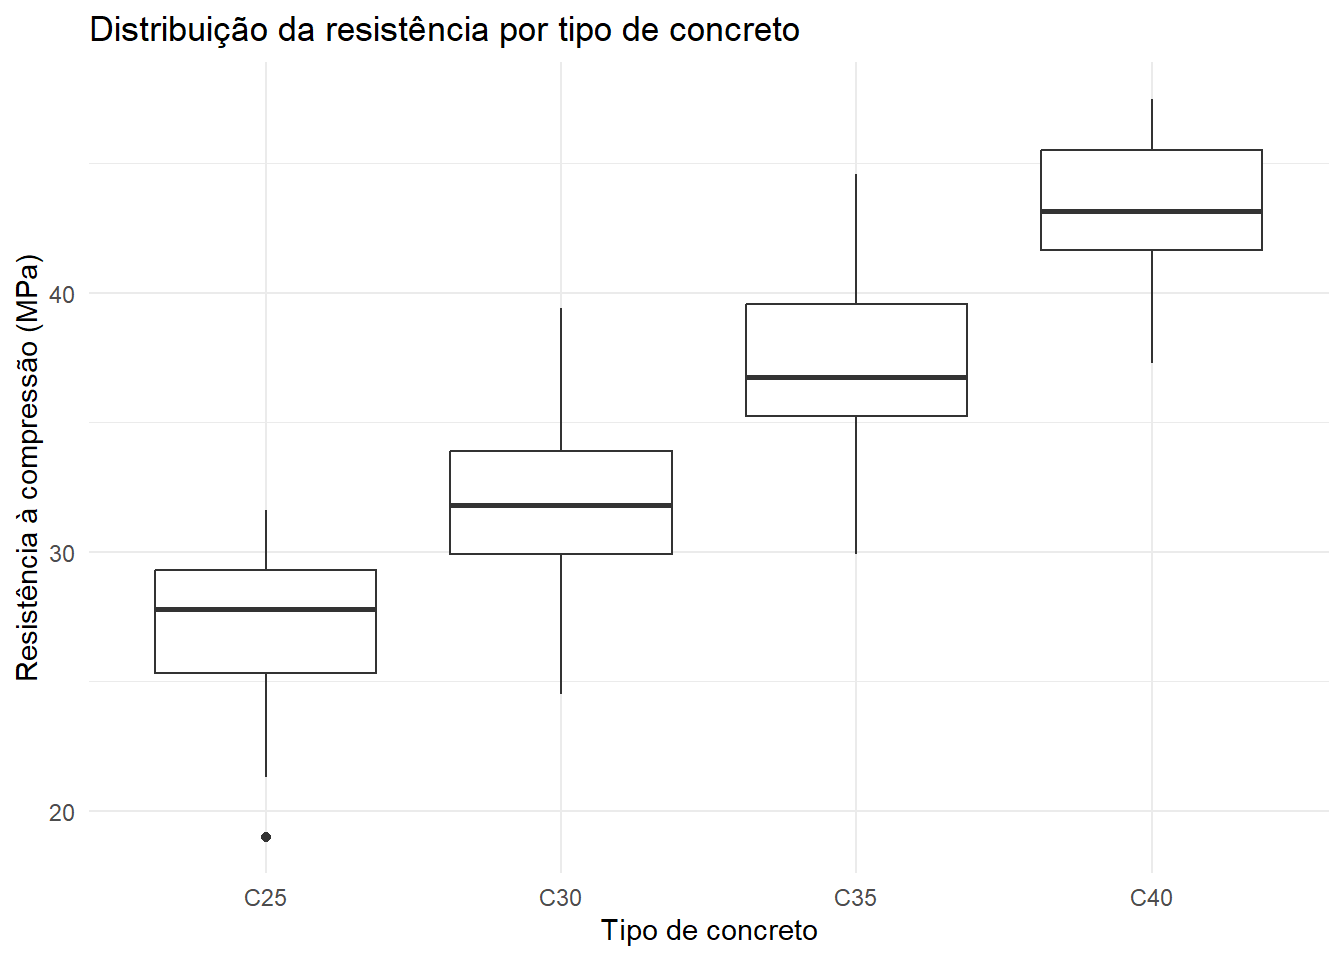
O gráfico evidencia o deslocamento progressivo da distribuição da resistência à medida que a classe aumenta. As medianas são aproximadamente 27,8 MPa para C25, 31,8 MPa para C30, 36,75 MPa para C35 e 43,15 MPa para C40.
Apesar de existir alguma sobreposição entre classes vizinhas, o padrão geral é claro. O C25 apresenta ainda um valor baixo de aproximadamente 19 MPa que aparece como ponto atípico no boxplot e merece atenção, embora um ponto gráfico isolado não deva ser classificado automaticamente como erro.
#### Questão 34 — Consumo de cimento e resistência
```{r}
# Visão geral
ggplot(
  dados_limpos,
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa,
    color = tipo_concreto
  )
) +
  geom_point() +
  geom_smooth(
    aes(group = 1),
    method = "lm",
    se = FALSE,
    color = "black"
  ) +
  labs(
    title = "Consumo de cimento e resistência à compressão",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)",
    color = "Classe"
  ) +
  theme_minimal()
# Relação observada dentro de cada classe
ggplot(
  dados_limpos,
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa
  )
) +
  geom_point() +
  geom_smooth(
    method = "lm",
    se = FALSE
  ) +
  facet_wrap(~ tipo_concreto, scales = "free_x") +
  labs(
    title = "Consumo de cimento e resistência dentro de cada classe",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
```
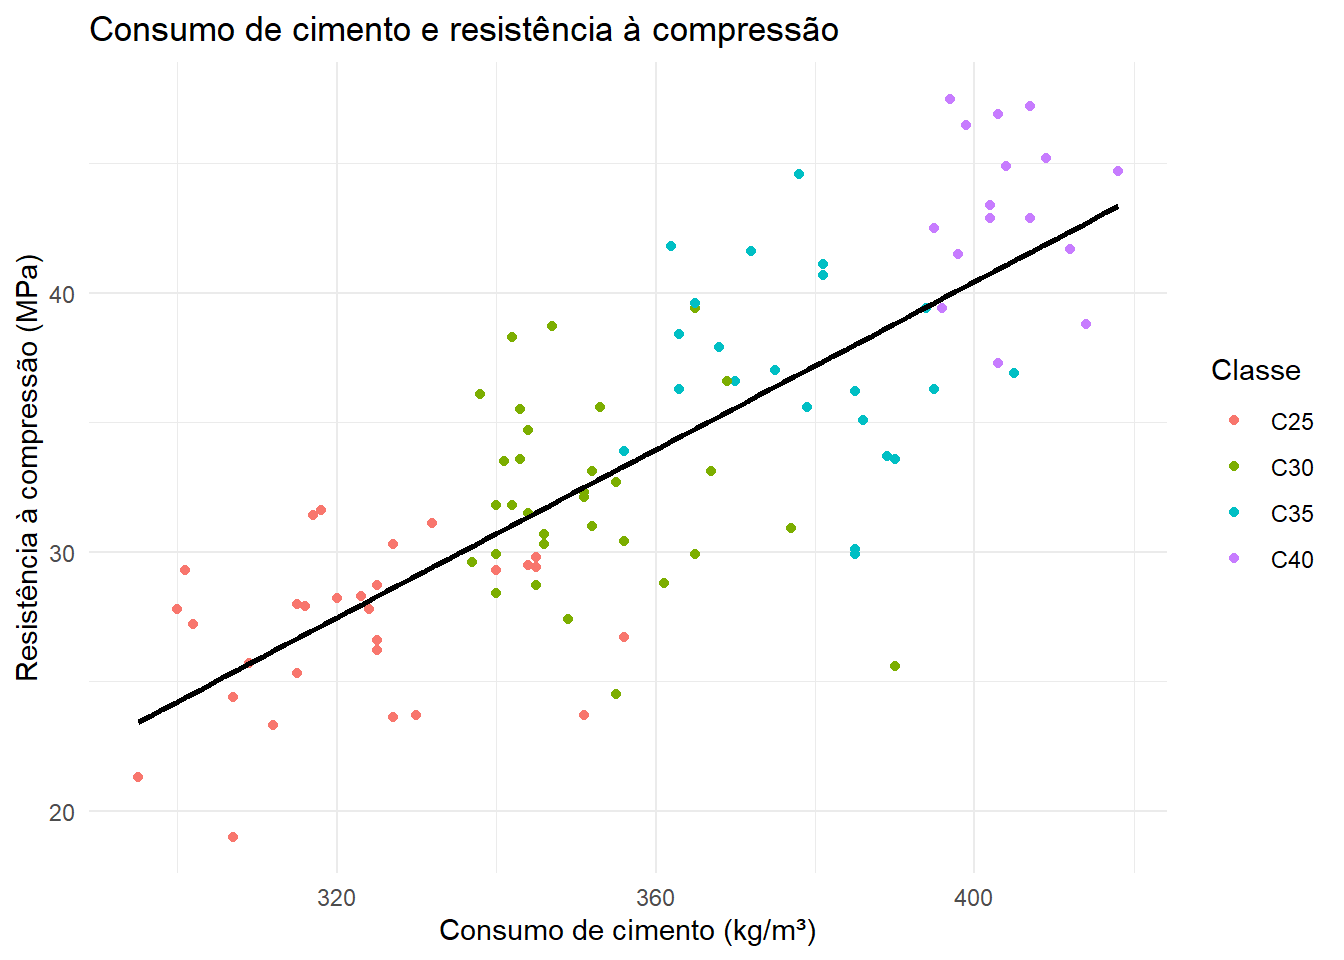
Considerando toda a base, existe uma associação positiva evidente entre consumo de cimento e resistência, com correlação de aproximadamente **0,78**. Visualmente, as classes de maior resistência também se concentram em maiores consumos de cimento.
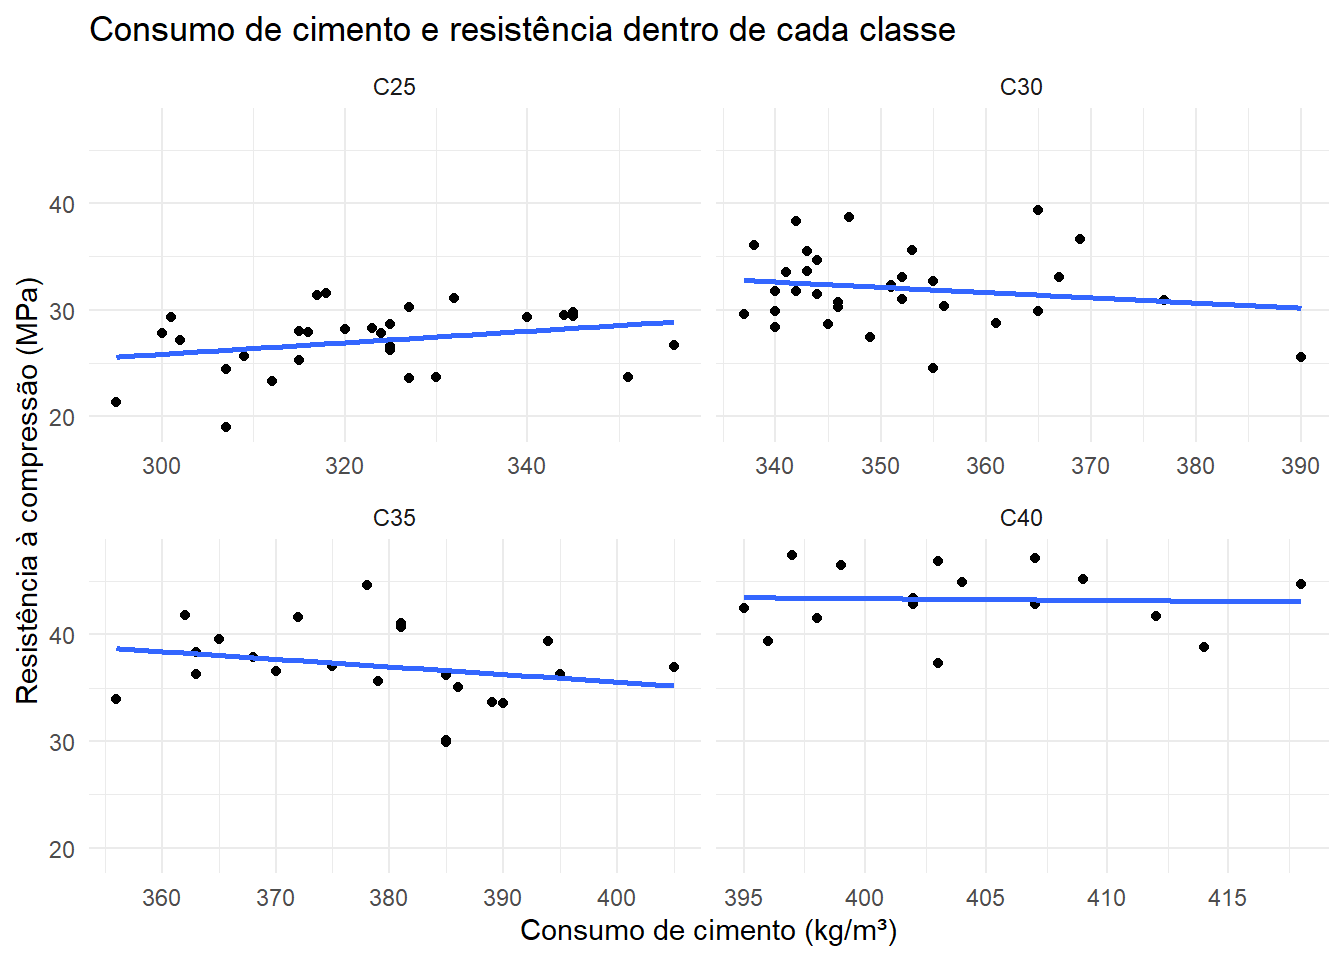
Entretanto, a análise separada por classe mostra uma interpretação diferente. As correlações são aproximadamente **0,28 no C25, -0,17 no C30, -0,24 no C35 e -0,04 no C40**, ou seja, fracas ou praticamente inexistentes dentro das próprias classes.
Dessa forma, o gráfico geral fornece evidência visual de associação, mas **não é suficiente para concluir que simplesmente aumentar o consumo de cimento produz maior resistência**. Parte importante do padrão observado está associada às diferenças de dosagem entre as próprias classes.
#### Questão 35 — Relação água/cimento e resistência
```{r}
# Visão geral
ggplot(
  dados_limpos,
  aes(
    x = relacao_a_c,
    y = resistencia_mpa,
    color = tipo_concreto
  )
) +
  geom_point() +
  geom_smooth(
    aes(group = 1),
    method = "lm",
    se = FALSE,
    color = "black"
  ) +
  labs(
    title = "Relação água/cimento e resistência à compressão",
    x = "Relação água/cimento",
    y = "Resistência à compressão (MPa)",
    color = "Classe"
  ) +
  theme_minimal()
# Relação dentro das classes
ggplot(
  dados_limpos,
  aes(
    x = relacao_a_c,
    y = resistencia_mpa
  )
) +
  geom_point() +
  geom_smooth(
    method = "lm",
    se = FALSE
  ) +
  facet_wrap(~ tipo_concreto) +
  labs(
    title = "Relação água/cimento e resistência dentro de cada classe",
    x = "Relação água/cimento",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
```
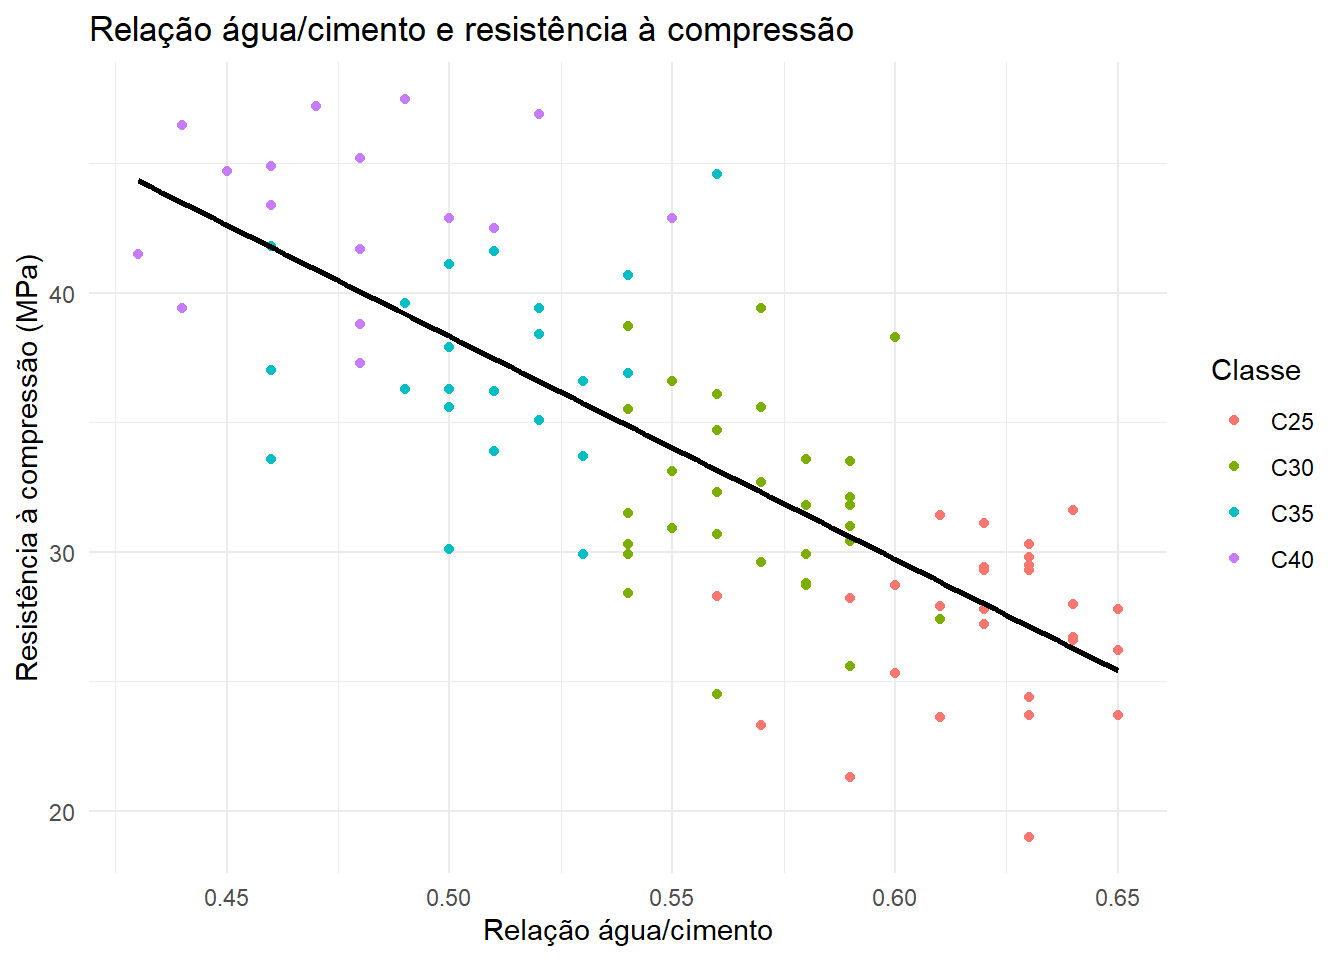
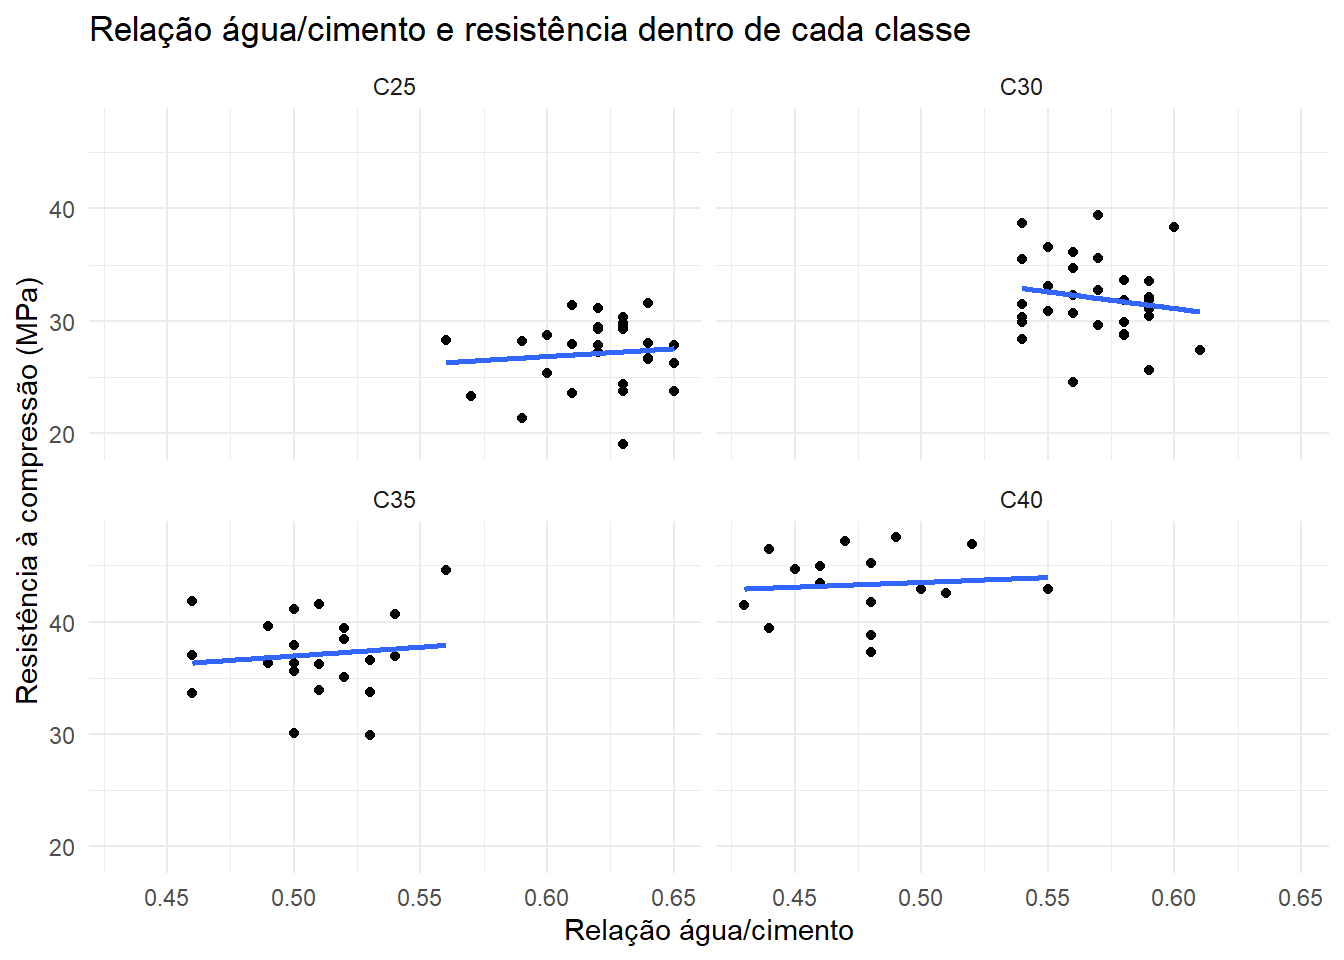
Na base completa, observa-se uma tendência negativa relativamente forte, com correlação de aproximadamente **-0,76**: valores maiores de relação água/cimento aparecem associados, de forma geral, a menores resistências.
Quando as classes são analisadas separadamente, entretanto, as correlações ficam próximas de zero: aproximadamente 0,10 no C25, -0,17 no C30, 0,11 no C35 e 0,09 no C40. Assim, a tendência negativa geral merece investigação, mas não deve ser interpretada isoladamente como uma relação direta de mesma intensidade dentro de todas as classes.
### Etapa 10 – Questões próximas da prática profissional
#### Questão 36 — Comparação entre obras
A afirmação de que o Bloco C apresenta desempenho superior foi avaliada em três níveis: resistência média por bloco; médias das propriedades por bloco; e comparação entre bloco e tipo de concreto.
```{r}
# 1. Resistência média por bloco
resumo_resistencia_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))

resumo_resistencia_obra
# 2. Médias das propriedades por bloco
resumo_propriedades_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    across(
      all_of(variaveis_propriedades),
      ~ mean(.x, na.rm = TRUE)
    ),
    .groups = "drop"
  )

resumo_propriedades_obra
# 3. Médias das propriedades por bloco e classe
resumo_obra_classe <- dados_limpos |>
  group_by(obra, tipo_concreto) |>
  summarise(
    across(
      all_of(variaveis_propriedades),
      ~ mean(.x, na.rm = TRUE)
    ),
    .groups = "drop"
  )

resumo_obra_classe
# Distribuição da resistência entre os blocos, controlando visualmente a classe
ggplot(
  dados_limpos,
  aes(
    x = obra,
    y = resistencia_mpa
  )
) +
  geom_boxplot() +
  facet_wrap(~ tipo_concreto) +
  labs(
    title = "Resistência por bloco e tipo de concreto",
    x = "Bloco",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal() +
  theme(
    axis.text.x = element_text(
      angle = 45,
      hjust = 1
    )
  )
```
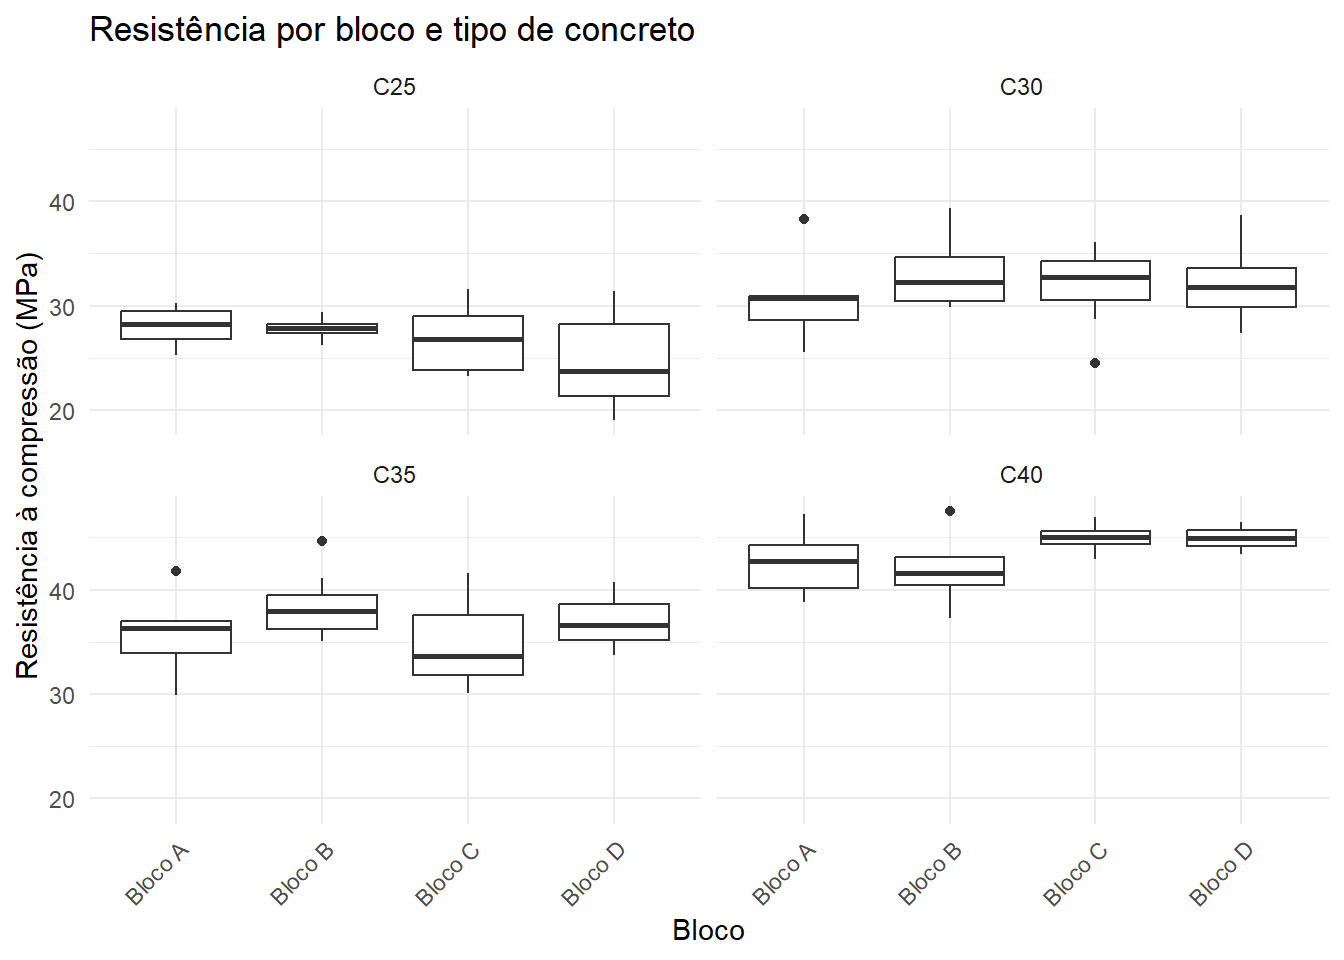
Na análise geral, o Bloco C **não apresenta a maior resistência média**. Sua média é de aproximadamente **32,37 MPa**, enquanto o Bloco B apresenta 35,70 MPa. O Bloco C possui, entretanto, o menor consumo médio de cimento, aproximadamente **349,79 kg/m³**.
A comparação apenas das médias gerais não é suficiente porque cada bloco contém diferentes proporções de classes. Ao separar as classes, o C25 do Bloco C apresenta resistência média de 26,90 MPa; no C30, 32,02 MPa; no C35, 35,10 MPa; e no C40, 44,98 MPa.
No **C30**, o Bloco C apresenta resistência próxima aos melhores resultados com o menor consumo médio de cimento e a menor relação água/cimento entre os blocos, constituindo um resultado interessante. No **C35**, entretanto, apresenta a menor resistência média e o maior consumo de cimento. No **C40**, apresenta a maior resistência média, praticamente empatada com o Bloco D, porém com o maior consumo de cimento.
Portanto, os dados indicam **bons resultados pontuais do Bloco C, principalmente em C30 e C40, mas não sustentam uma superioridade geral e consistente**. Além disso, abatimento, densidade e absorção não devem ser tratados como um simples placar em que maior ou menor significa necessariamente melhor; a interpretação depende do objetivo e da especificação técnica de cada propriedade.
#### Questão 37 — Idade e resistência
```{r}
# Média geral por idade
medias_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )

medias_idade
# Média por classe e idade
medias_idade_classe <- dados_limpos |>
  group_by(tipo_concreto, idade_dias) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )

medias_idade_classe
ggplot(
  medias_idade_classe,
  aes(
    x = idade_dias,
    y = resistencia_media,
    color = tipo_concreto,
    group = tipo_concreto
  )
) +
  geom_point() +
  geom_line() +
  scale_x_continuous(
    breaks = c(7, 14, 28, 56)
  ) +
  labs(
    title = "Resistência média por idade e classe de concreto",
    x = "Idade (dias)",
    y = "Resistência média (MPa)",
    color = "Classe"
  ) +
  theme_minimal()
```
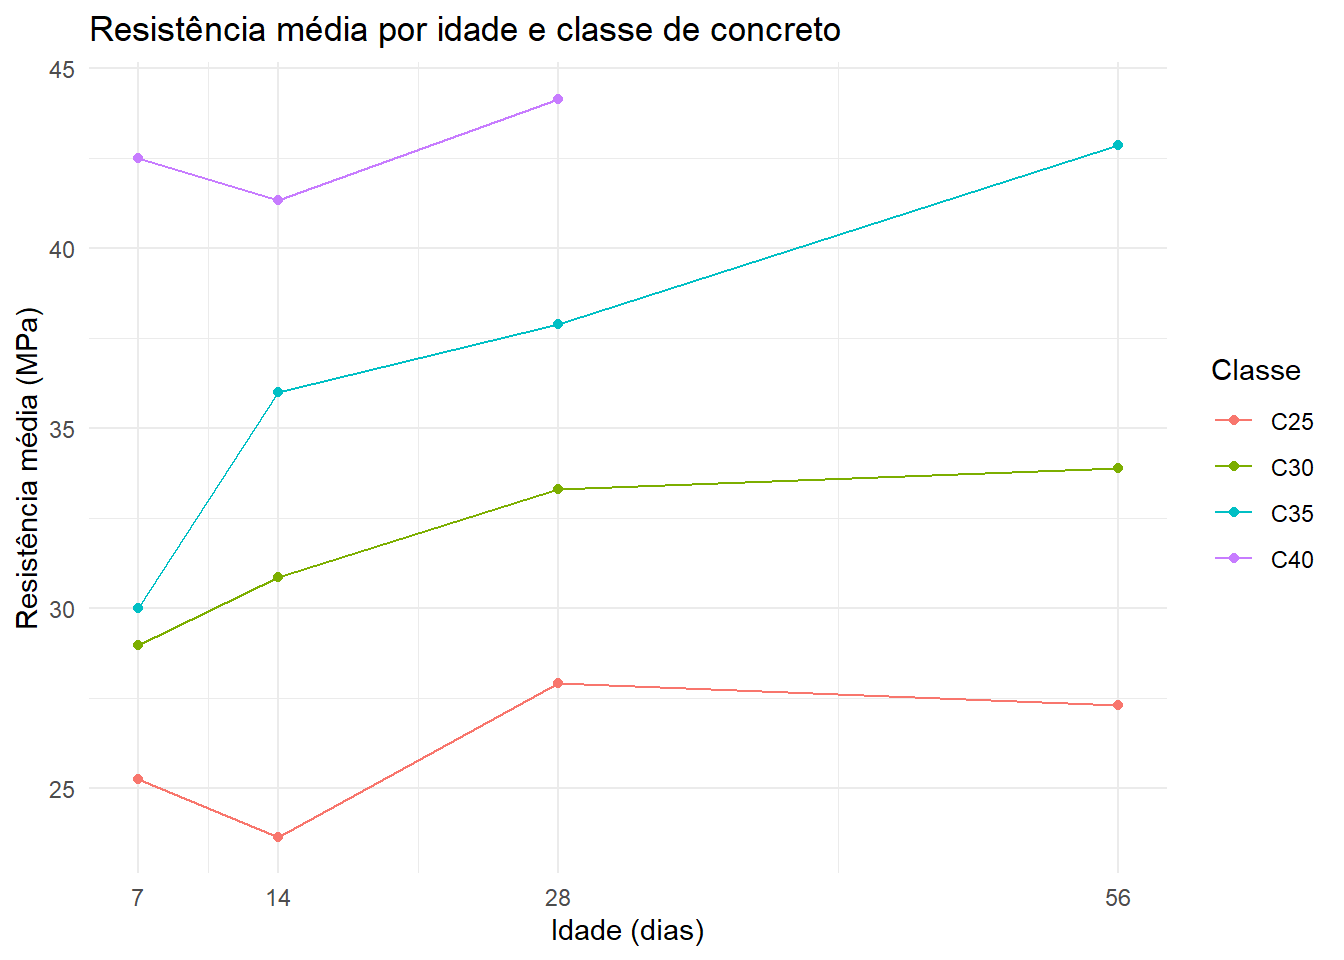
Considerando todos os concretos em conjunto, as médias são **28,78 MPa aos 7 dias, 34,74 MPa aos 14 dias, 34,65 MPa aos 28 dias e 33,12 MPa aos 56 dias**. Essa média geral não apresenta crescimento contínuo.
Quando a classe é controlada, o padrão torna-se mais informativo. O C30 aumenta de 28,96 MPa aos 7 dias para 33,88 MPa aos 56 dias, enquanto o C35 aumenta de 30,00 para 42,85 MPa. O C25 apresenta maior oscilação, e o C40 não possui observações aos 56 dias.
Portanto, a base apresenta **evidência de aumento da resistência com a idade principalmente nas classes C30 e C35**, mas esse comportamento não é uniforme em todas as classes. Como os registros correspondem a diferentes corpos de prova, a análise deve ser interpretada como tendência descritiva, e não como acompanhamento longitudinal de um mesmo corpo de prova.
#### Questão 38 — Resumo para o engenheiro
```{r}
tabela_engenheiro <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    resistencia_mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    resistencia_minima = min(resistencia_mpa, na.rm = TRUE),
    resistencia_maxima = max(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )

tabela_engenheiro
```
Para o acompanhamento da qualidade do concreto, considero especialmente relevantes as seguintes informações:
**Número de ensaios (`n`)** — permite avaliar a quantidade de resultados disponível em cada classe e evita interpretar uma média sem conhecer o tamanho do grupo.
**Resistência média** — resume o nível geral de resistência observado na classe e facilita comparações entre grupos.
**Mediana** — complementa a média e é menos sensível a valores extremos, permitindo verificar se a distribuição está sendo influenciada por observações isoladas.
**Desvio-padrão** — representa a dispersão dos resultados e auxilia a avaliar a uniformidade do comportamento da classe.
**Resistência mínima** — possui importância prática por evidenciar os resultados mais baixos, que podem exigir investigação mesmo quando a média do grupo é satisfatória.
**Resistência máxima** — completa a avaliação da amplitude observada e ajuda a compreender os extremos da distribuição.
A apresentação conjunta dessas estatísticas é mais informativa do que utilizar apenas a resistência média, pois permite analisar quantidade de dados, tendência central, variabilidade e extremos.
---
## Desafio final — O engenheiro responsável pelos dados
O script a seguir prioriza ferramentas da família `tidyverse` e foi organizado em duas ideias. A primeira corresponde a uma **inspeção genérica**, capaz de atuar sem conhecer previamente os erros específicos. A segunda corresponde à interpretação técnica, que deve ser realizada depois que o profissional conhece o significado das variáveis.
```{r}
# ============================================================
# DESAFIO FINAL - SCRIPT GENÉRICO COM TIDYVERSE
# ============================================================

library(tidyverse)

# 1. Importação e preservação da base original ----------------

dados_desafio <- read_csv2(
  "base_processamento_dados_engenharia_civil.csv",
  show_col_types = FALSE
)

dados_original_desafio <- dados_desafio


# 2. Inspeção inicial -----------------------------------------

dados_desafio |>
  glimpse()
dados_desafio |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  )
# 3. Padronizações inequívocas --------------------------------
# Remove espaços no início/final e transforma textos vazios em NA.

dados_desafio <- dados_desafio |>
  mutate(
    across(
      where(is.character),
      ~ .x |>
        str_trim() |>
        na_if("")
    )
  )


# 4. Verificação de linhas duplicadas -------------------------

duplicados <- dados_desafio |>
  group_by(
    across(everything())
  ) |>
  filter(n() > 1) |>
  ungroup()

duplicados
# 5. Identificação de colunas predominantemente numéricas -----

proporcao_numerica <- dados_desafio |>
  select(where(is.character)) |>
  map_dbl(
    ~ {
      valores <- .x[!is.na(.x)]

      if (length(valores) == 0) {
        return(0)
      }

      convertidos <- valores |>
        str_replace_all(",", ".") |>
        parse_double()

      mean(!is.na(convertidos))
    }
  )

candidatas_numericas <- tibble(
  variavel = names(proporcao_numerica),
  proporcao_numerica = proporcao_numerica
) |>
  filter(proporcao_numerica >= 0.90)

candidatas_numericas
# 6. Registro de valores que impedem a conversão --------------

pendencias_conversao <- candidatas_numericas$variavel |>
  map_dfr(
    function(variavel_atual) {

      dados_desafio |>
        transmute(
          linha = row_number(),
          variavel = variavel_atual,
          valor_original = .data[[variavel_atual]],
          valor_convertido =
            valor_original |>
              str_replace_all(",", ".") |>
              parse_double()
        ) |>
        filter(
          !is.na(valor_original),
          is.na(valor_convertido)
        ) |>
        select(
          linha,
          variavel,
          valor_original
        )
    }
  )

pendencias_conversao
# 7. Conversão das colunas candidatas --------------------------
# Os valores não convertíveis passam a NA na base de trabalho,
# mas permanecem registrados em pendencias_conversao.

dados_desafio <- dados_desafio |>
  mutate(
    across(
      all_of(candidatas_numericas$variavel),
      ~ .x |>
        str_replace_all(",", ".") |>
        parse_double()
    )
  )


# 8. Possíveis inconsistências entre categorias ---------------

inconsistencias_categorias <- dados_desafio |>
  select(where(is.character)) |>
  mutate(linha = row_number(), .before = 1) |>
  pivot_longer(
    -linha,
    names_to = "variavel",
    values_to = "valor"
  ) |>
  filter(!is.na(valor)) |>
  mutate(
    chave = str_to_lower(valor)
  ) |>
  distinct(
    variavel,
    chave,
    valor
  ) |>
  group_by(
    variavel,
    chave
  ) |>
  summarise(
    n_formas = n(),
    formas = str_c(valor, collapse = " | "),
    .groups = "drop"
  ) |>
  filter(n_formas > 1)

inconsistencias_categorias
# 9. Possíveis valores atípicos -------------------------------
# O critério do IQR apenas sinaliza valores para análise.
# Um outlier estatístico não é automaticamente um erro.

variaveis_numericas_desafio <- dados_desafio |>
  select(where(is.numeric)) |>
  names()

possiveis_outliers <- dados_desafio |>
  mutate(linha = row_number()) |>
  pivot_longer(
    cols = all_of(variaveis_numericas_desafio),
    names_to = "variavel",
    values_to = "valor"
  ) |>
  filter(!is.na(valor)) |>
  group_by(variavel) |>
  mutate(
    q1 = quantile(valor, 0.25),
    q3 = quantile(valor, 0.75),
    iqr = IQR(valor),
    limite_inferior = q1 - 1.5 * iqr,
    limite_superior = q3 + 1.5 * iqr
  ) |>
  filter(
    valor < limite_inferior |
      valor > limite_superior
  ) |>
  select(
    linha,
    variavel,
    valor
  ) |>
  ungroup()

possiveis_outliers
# 10. Variáveis derivadas de qualidade -------------------------

dados_desafio <- dados_desafio |>
  mutate(
    n_ausentes_linha = rowSums(
      is.na(pick(everything()))
    ),
    registro_completo =
      n_ausentes_linha == 0
  )

dados_desafio |>
  count(registro_completo)
# 11. Estatísticas descritivas --------------------------------

dados_desafio |>
  select(
    where(is.numeric),
    -n_ausentes_linha
  ) |>
  summarise(
    across(
      everything(),
      list(
        media = ~ mean(.x, na.rm = TRUE),
        mediana = ~ median(.x, na.rm = TRUE),
        dp = ~ sd(.x, na.rm = TRUE)
      )
    )
  )
# 12. Gráfico 1 - distribuição das variáveis numéricas --------
# O uso de escalas livres permite inspecionar variáveis
# originalmente medidas em unidades diferentes.

dados_desafio |>
  select(
    where(is.numeric),
    -n_ausentes_linha
  ) |>
  pivot_longer(
    everything(),
    names_to = "variavel",
    values_to = "valor"
  ) |>
  ggplot(
    aes(x = valor)
  ) +
  geom_histogram(
    bins = 20
  ) +
  facet_wrap(
    ~ variavel,
    scales = "free"
  ) +
  labs(
    title = "Distribuição das variáveis quantitativas",
    x = "Valor",
    y = "Frequência"
  ) +
  theme_minimal()
# 13. Gráfico 2 - valores ausentes por variável ---------------

dados_desafio |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  ) |>
  pivot_longer(
    everything(),
    names_to = "variavel",
    values_to = "n_ausentes"
  ) |>
  ggplot(
    aes(
      x = reorder(
        variavel,
        n_ausentes
      ),
      y = n_ausentes
    )
  ) +
  geom_col() +
  coord_flip() +
  labs(
    title = "Valores ausentes por variável",
    x = "Variável",
    y = "Número de valores ausentes"
  ) +
  theme_minimal()
# 14. Resumo das pendências -----------------------------------

list(
  valores_ausentes =
    dados_desafio |>
      summarise(
        across(
          everything(),
          ~ sum(is.na(.x))
        )
      ),

  problemas_conversao =
    pendencias_conversao,

  inconsistencias_categoricas =
    inconsistencias_categorias,

  possiveis_outliers =
    possiveis_outliers
)
```
O script preserva a base original, padroniza espaços e campos vazios, identifica colunas predominantemente numéricas, registra os valores que não podem ser convertidos, procura inconsistências categóricas e sinaliza possíveis valores atípicos.
A conversão automática é limitada às colunas em que pelo menos 90% dos valores preenchidos apresentam formato numérico. Esse critério torna o procedimento mais geral, mas não elimina a necessidade de julgamento profissional: códigos formados apenas por números, por exemplo, podem exigir decisão diferente.
Os outliers também são apenas sinalizados. O próprio banco de concreto mostra a importância dessa escolha, pois o critério estatístico pode destacar tanto erros evidentes de ordem de grandeza quanto valores legítimos localizados nas extremidades da distribuição.
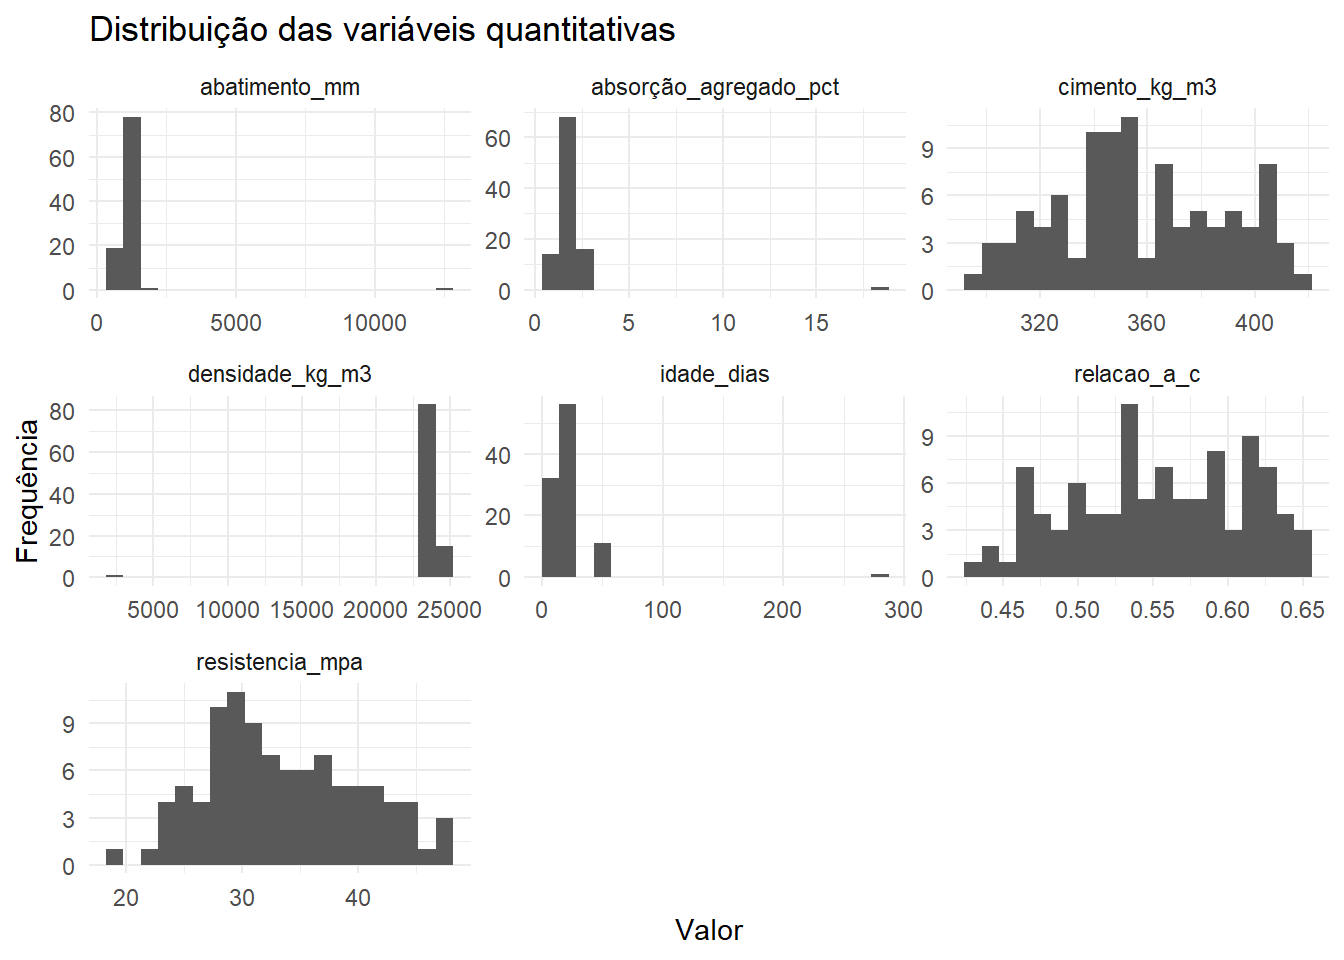
As variáveis derivadas `n_ausentes_linha` e `registro_completo` permitem avaliar a qualidade de preenchimento de cada registro. Os dois gráficos produzidos fornecem uma visão geral das distribuições quantitativas e da ocorrência de valores ausentes.
Dessa forma, o script automatiza tarefas de inspeção e padronização, mas mantém separadas as decisões que dependem do contexto técnico da base.
## Reflexão final
### Base R e tidyverse
A principal diferença observada entre a resolução com Base R e com `tidyverse` está na forma de estruturar o processamento. No Base R, diferentes tarefas podem exigir sintaxes e estruturas específicas, como `tapply()`, `aggregate()`, `apply()`, `subset()` e indexações. No `tidyverse`, as operações são organizadas a partir de verbos com funções mais específicas, como `filter()`, `select()`, `mutate()`, `group_by()` e `summarise()`, frequentemente conectadas pelo operador `|>`.
Na prática deste relatório, o `tidyverse` tornou especialmente claras as operações agrupadas e as transformações sucessivas da base. Funções como `across()` também facilitaram a aplicação da mesma operação a várias variáveis sem repetição excessiva. Isso não significa que Base R seja inadequado; as duas abordagens são capazes de resolver os problemas propostos. A diferença principal está na organização e na legibilidade do fluxo de trabalho.
### Importância do processamento e da limpeza
O processamento e a limpeza dos dados são etapas fundamentais antes da aplicação de métodos estatísticos porque erros de digitação, valores ausentes, inconsistências de categorias ou ordens de grandeza incorretas podem alterar médias, medidas de dispersão, correlações e representações gráficas. Na Engenharia Civil, essas análises podem subsidiar decisões técnicas e, portanto, a qualidade do resultado depende diretamente da qualidade da informação utilizada.
### Problemas encontrados, decisões e funções utilizadas
Os principais problemas encontrados envolveram duas situações: **erros de digitação e formatação**, como caracteres indevidos, separadores decimais diferentes e categorias sem padronização; e **valores numericamente válidos, mas potencialmente incompatíveis**, que exigem análise técnica antes de qualquer correção.
Foram utilizadas principalmente as funções `read_csv2()`, `glimpse()`, `filter()`, `select()`, `mutate()`, `summarise()`, `group_by()`, `arrange()`, `count()`, `distinct()`, `across()`, `case_when()`, `str_trim()`, `str_to_upper()`, `str_detect()`, `parse_double()`, `map()` e funções do `ggplot2`.
A solução adotada é adequada porque automatiza padronizações e operações repetitivas, preserva a base original e permite identificar situações que necessitam de verificação. Ao mesmo tempo, evita tratar toda observação estatisticamente diferente como erro, mantendo a interpretação técnica como parte essencial do processamento.
## 🧠 Considerações finais
O desenvolvimento deste relatório permitiu aplicar a família `tidyverse` ao processamento e à análise de dados relacionados ao controle tecnológico do concreto. Em comparação com o Relatório 02, as mesmas etapas fundamentais de inspeção, limpeza, transformação e exploração foram realizadas por meio de uma lógica baseada em fluxos de dados e funções especializadas.
A atividade evidenciou novamente que a qualidade da análise estatística depende da qualidade da base utilizada. Erros de digitação, categorias não padronizadas, valores ausentes e registros com ordem de grandeza incompatível podem alterar resultados aparentemente simples. As ferramentas de `dplyr`, `stringr` e `readr` permitiram organizar essas etapas de forma sequencial e legível, enquanto `ggplot2` acrescentou uma dimensão visual importante para a interpretação das distribuições e relações entre variáveis.
As análises também reforçaram a necessidade de interpretação técnica. A associação geral entre consumo de cimento e resistência, por exemplo, mostrou-se forte quando toda a base foi considerada, mas fraca quando as classes foram avaliadas separadamente. Da mesma forma, a resistência média por idade só apresentou interpretação mais adequada quando a classe do concreto foi considerada simultaneamente.
Por fim, o `tidyverse` mostrou-se especialmente útil para operações agrupadas, aplicação simultânea de funções a várias colunas e construção de gráficos integrados ao fluxo de análise. Entretanto, nenhuma ferramenta substitui a avaliação do significado físico dos dados. O R permite organizar e explorar a informação, mas a decisão sobre a validade e a relevância dos resultados continua dependendo do julgamento técnico do profissional.
## 📖 Referências
::: {#refs}
:::