---
# Só mude aqui!!!!
author: "Leonardo Müller"
title: "Relatório 01"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
```{r}
#| label: configuracao
#| include: false
options(
digits = 4,
scipen = 999,
OutDec = ","
)
arquivo_csv <- c(
"1 - MONITORAMENTO CONSOLIDADO - PDE ÁGUA PRETA.csv",
file.path("dados", "1 - MONITORAMENTO CONSOLIDADO - PDE ÁGUA PRETA.csv"),
file.path("upload", "1 - MONITORAMENTO CONSOLIDADO - PDE ÁGUA PRETA.csv")
)
arquivo_csv <- arquivo_csv[file.exists(arquivo_csv)][1]
if (is.na(arquivo_csv)) {
stop("O arquivo CSV de monitoramento não foi encontrado. Coloque-o na mesma pasta do index.qmd ou na pasta dados/.")
}
br_num <- function(x) {
formatC(x, format = "f", digits = 2, decimal.mark = ",", big.mark = ".")
}
coef_assimetria <- function(x) {
x <- x[is.finite(x)]
m2 <- mean((x - mean(x))^2)
if (length(x) < 3 || m2 == 0) return(NA_real_)
mean((x - mean(x))^3) / (m2^(3/2))
}
coef_curtose <- function(x) {
x <- x[is.finite(x)]
m2 <- mean((x - mean(x))^2)
if (length(x) < 4 || m2 == 0) return(NA_real_)
mean((x - mean(x))^4) / (m2^2)
}
contar_outliers <- function(x) {
x <- x[is.finite(x)]
limites <- boxplot.stats(x)$stats[c(1, 5)]
sum(x < limites[1] | x > limites[2])
}
```
## 📌 Introdução
O monitoramento geotécnico é uma ferramenta importante para acompanhar o comportamento e as condições de segurança de estruturas como pilhas de estéril. Entre as variáveis monitoradas está o nível d'água (NA), cuja evolução fornece informações sobre as condições hidrogeotécnicas da estrutura. Contudo, a obtenção das leituras, isoladamente, não é suficiente para compreender seu comportamento. É necessário organizar, representar e interpretar os registros para transformá-los em informações úteis.
Nesse contexto, a Estatística Descritiva permite sintetizar um conjunto de dados por meio de tabelas, gráficos e medidas numéricas. Com esses recursos, é possível identificar valores típicos, avaliar a dispersão das leituras, caracterizar a forma das distribuições e reconhecer observações potencialmente discrepantes.
O ambiente R auxilia esse processo ao reunir recursos para importação, tratamento, análise e representação gráfica dos dados. Suas funcionalidades também podem ser ampliadas por pacotes, como o `leem` (*Laboratory of Teaching to Statistics and Mathematics*), voltado ao ensino e à aplicação de conceitos estatísticos.
Neste trabalho, os fundamentos da linguagem R e da Estatística Descritiva são aplicados a um banco de dados de monitoramento da PDE Água Preta. A análise considera as cotas de nível d'água registradas pelos instrumentos, com ênfase nas medidas de posição, dispersão, assimetria e curtose, além da avaliação gráfica e temporal das leituras.
## 🎯 Objetivos
### Objetivo geral
Aplicar os fundamentos da linguagem R e da Estatística Descritiva na organização, análise e interpretação dos dados de nível d'água da PDE Água Preta.
### Objetivos específicos
- Importar, inspecionar e organizar o banco de dados de monitoramento;
- identificar registros ausentes e possíveis inconsistências;
- calcular medidas de posição, dispersão e forma para cada instrumento;
- representar graficamente a evolução e a distribuição das cotas de nível d'água;
- identificar possíveis valores discrepantes;
- interpretar os resultados no contexto do monitoramento geotécnico.
------------------------------------------------------------------------
## 📚 Fundamentação Teórica
### Introdução à linguagem R
O R é uma linguagem de programação e um ambiente de software livre direcionado à computação estatística, à manipulação de dados e à produção gráfica. Sua estrutura permite realizar desde operações matemáticas elementares até análises de conjuntos de dados. No ambiente R, as informações são armazenadas em objetos, que podem assumir estruturas como vetores, matrizes, listas e *data frames* [@Rbasico2022].
O R pode ser utilizado em conjunto com o RStudio, uma interface que facilita a elaboração e a execução de *scripts*, a visualização dos objetos e o gerenciamento dos arquivos. O registro da análise em código permite ainda que os procedimentos sejam verificados e reproduzidos posteriormente.
### Pacotes no ambiente R
As funcionalidades do R podem ser ampliadas por pacotes, que reúnem funções, dados e documentações desenvolvidos para aplicações específicas. Um pacote pode ser instalado com a função `install.packages()` e carregado na sessão por meio da função `library()`.
Neste trabalho, considera-se o pacote `leem`, denominado *Laboratory of Teaching to Statistics and Mathematics*. O pacote foi desenvolvido para auxiliar o ensino de Estatística e Matemática no ambiente R e apresenta recursos relacionados à organização, tabulação e representação dos dados. Sua utilização deve ser acompanhada da compreensão dos conceitos estatísticos envolvidos, pois a execução automática dos cálculos não substitui a interpretação dos resultados.
### Estatística Descritiva
A Estatística Descritiva reúne procedimentos utilizados para organizar, resumir e apresentar um conjunto de dados. Essa descrição pode ser realizada por meio de distribuições de frequência, representações gráficas e medidas numéricas. Para dados de monitoramento, a análise temporal também é necessária, pois preserva a sequência em que as observações foram registradas.
### Média aritmética
A média aritmética é uma medida de posição que representa o valor central de um conjunto de observações. Para uma amostra com (n) valores, é determinada por:
$$
\bar{x}=\frac{\sum_{i=1}^{n}x_i}{n}
$$
No monitoramento de nível d'água, a média representa a cota média registrada por um instrumento no período analisado. Entretanto, sua interpretação deve ser realizada juntamente com medidas de dispersão e gráficos, uma vez que séries com médias semelhantes podem apresentar comportamentos diferentes.
### Variância e desvio padrão
A variância mede a dispersão das observações em relação à média. Para uma amostra, é calculada por:
$$
s^2=\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}
$$
O desvio padrão corresponde à raiz quadrada da variância:
$$
s=\sqrt{s^2}
$$
Como o desvio padrão é expresso na mesma unidade da variável original, sua interpretação é mais direta. Valores menores indicam maior concentração das observações em torno da média, enquanto valores maiores evidenciam maior variabilidade das leituras.
### Amostragem
Uma população corresponde ao conjunto completo de elementos de interesse, enquanto uma amostra representa uma parte desse conjunto. A amostragem é o processo de obtenção das observações utilizadas no estudo. Neste trabalho, as leituras pertencem a séries temporais de monitoramento e, portanto, não devem ser interpretadas automaticamente como repetições experimentais independentes.
### Assimetria
A assimetria avalia o afastamento da distribuição em relação à simetria. Um coeficiente baseado no terceiro momento pode ser expresso por:
$$
a_3=\frac{\sum_{i=1}^{n}(x_i-\bar{x})^3}{ns^3}
$$
Valores positivos indicam prolongamento da distribuição à direita; valores negativos indicam prolongamento à esquerda; e valores próximos de zero caracterizam uma distribuição aproximadamente simétrica.
### Curtose
A curtose complementa a análise da forma da distribuição e pode ser calculada a partir do quarto momento:
$$
a_4=\frac{\sum_{i=1}^{n}(x_i-\bar{x})^4}{ns^4}
$$
Adotando a distribuição normal como referência, valores superiores a 3 caracterizam uma distribuição leptocúrtica, valores inferiores a 3 indicam uma distribuição platicúrtica e o valor igual a 3 corresponde a uma distribuição mesocúrtica. A curtose deve ser interpretada em conjunto com a assimetria, as medidas de dispersão e os gráficos.
------------------------------------------------------------------------
## ⚙️ Metodologia
### Caracterização do estudo
O estudo foi realizado com dados de monitoramento de nível d'água da PDE Água Preta. A variável principal analisada foi a cota do nível d'água, expressa em metros, registrada pelos diferentes instrumentos ao longo do período disponível.
### Materiais utilizados
Foram utilizados o software R, o RStudio, o pacote `leem` como recurso complementar e o banco de dados `1 - MONITORAMENTO CONSOLIDADO - PDE ÁGUA PRETA.csv`.
### Procedimento
O arquivo foi importado para o R e verificado quanto à estrutura, às datas válidas, aos valores ausentes e à organização das colunas. Como a base possui duas linhas de cabeçalho e colunas separadoras vazias, os nomes dos instrumentos e das variáveis foram identificados antes da conversão para o formato longo.
Foram mantidas somente as linhas com datas válidas. Em seguida, as cotas foram convertidas do padrão decimal brasileiro para valores numéricos e organizadas por instrumento. Para cada série, foram calculados número de observações, média, mediana, variância, desvio padrão, valores mínimo e máximo, assimetria, curtose e quantidade de possíveis *outliers* pelo critério de 1,5 vez a amplitude interquartil. Por fim, foram elaborados gráficos de disponibilidade, evolução temporal e distribuição das leituras.
### Número de observações
Cada cota válida foi considerada uma observação. Como a disponibilidade varia entre os instrumentos e as leituras sucessivas pertencem a séries temporais, o número de registros foi apresentado separadamente para cada instrumento.
------------------------------------------------------------------------
## 🔍 Resultados e Discussão
### Importação e tratamento dos dados
```{r}
#| label: importacao-tratamento
dados_brutos <- read.csv2(
  arquivo_csv,
  header = FALSE,
  fill = TRUE,
  stringsAsFactors = FALSE,
  check.names = FALSE,
  fileEncoding = "latin1"
)

cabecalho_instrumentos <- trimws(as.character(dados_brutos[1, ]))
cabecalho_variaveis <- trimws(as.character(dados_brutos[2, ]))

# Propagação do nome do instrumento ao longo das respectivas colunas.
instrumento_coluna <- character(length(cabecalho_instrumentos))
instrumento_atual <- ""

for (i in seq_along(cabecalho_instrumentos)) {
  if (nzchar(cabecalho_instrumentos[i])) {
    instrumento_atual <- cabecalho_instrumentos[i]
  }
  instrumento_coluna[i] <- instrumento_atual
}

colunas_cota <- which(grepl("^Cota", cabecalho_variaveis, ignore.case = TRUE))
datas <- as.Date(trimws(as.character(dados_brutos[-c(1, 2), 1])), format = "%d/%m/%Y")
linhas_validas <- which(!is.na(datas)) + 2

lista_longos <- vector("list", length(colunas_cota))

for (j in seq_along(colunas_cota)) {
  coluna <- colunas_cota[j]
  valores <- trimws(as.character(dados_brutos[linhas_validas, coluna]))
  valores <- as.numeric(sub(",", ".", valores, fixed = TRUE))

  lista_longos[[j]] <- data.frame(
    data = datas[!is.na(datas)],
    instrumento = instrumento_coluna[coluna],
    cota = valores,
    stringsAsFactors = FALSE
  )
}

dados_longos <- do.call(rbind, lista_longos)
dados_longos <- dados_longos[is.finite(dados_longos$cota), ]
dados_longos <- dados_longos[order(dados_longos$instrumento, dados_longos$data), ]
rownames(dados_longos) <- NULL

periodo_inicial <- min(dados_longos$data)
periodo_final <- max(dados_longos$data)
numero_instrumentos <- length(unique(dados_longos$instrumento))
numero_observacoes <- nrow(dados_longos)
```
O banco original contém `r nrow(dados_brutos) - 2` linhas após o cabeçalho. Entretanto, apenas `r sum(!is.na(datas))` linhas apresentam datas válidas. As demais linhas sem data contêm, em diversas colunas, valores fixos relacionados à caracterização dos instrumentos e não foram consideradas como novas leituras. Após o tratamento, foram obtidas `r numero_observacoes` cotas válidas, distribuídas entre `r numero_instrumentos` instrumentos, no período de `r format(periodo_inicial, "%d/%m/%Y")` a `r format(periodo_final, "%d/%m/%Y")`.
Também foram identificadas duas datas repetidas no início da série. Como as linhas apresentam valores distintos e o banco não informa o horário das leituras, os registros foram preservados. Essa decisão evita a exclusão arbitrária de observações, mas a duplicidade deve ser confirmada no banco de origem.
### Disponibilidade das leituras
```{r}
#| label: disponibilidade
#| fig-cap: "Quantidade de cotas válidas por instrumento."
#| fig-width: 9
#| fig-height: 6
n_por_instrumento <- sort(table(dados_longos$instrumento))

par(mar = c(5, 9, 2, 1))
barplot(
  n_por_instrumento,
  horiz = TRUE,
  las = 1,
  col = "#2C7FB8",
  border = NA,
  xlab = "Número de observações",
  cex.names = 0.75
)
```
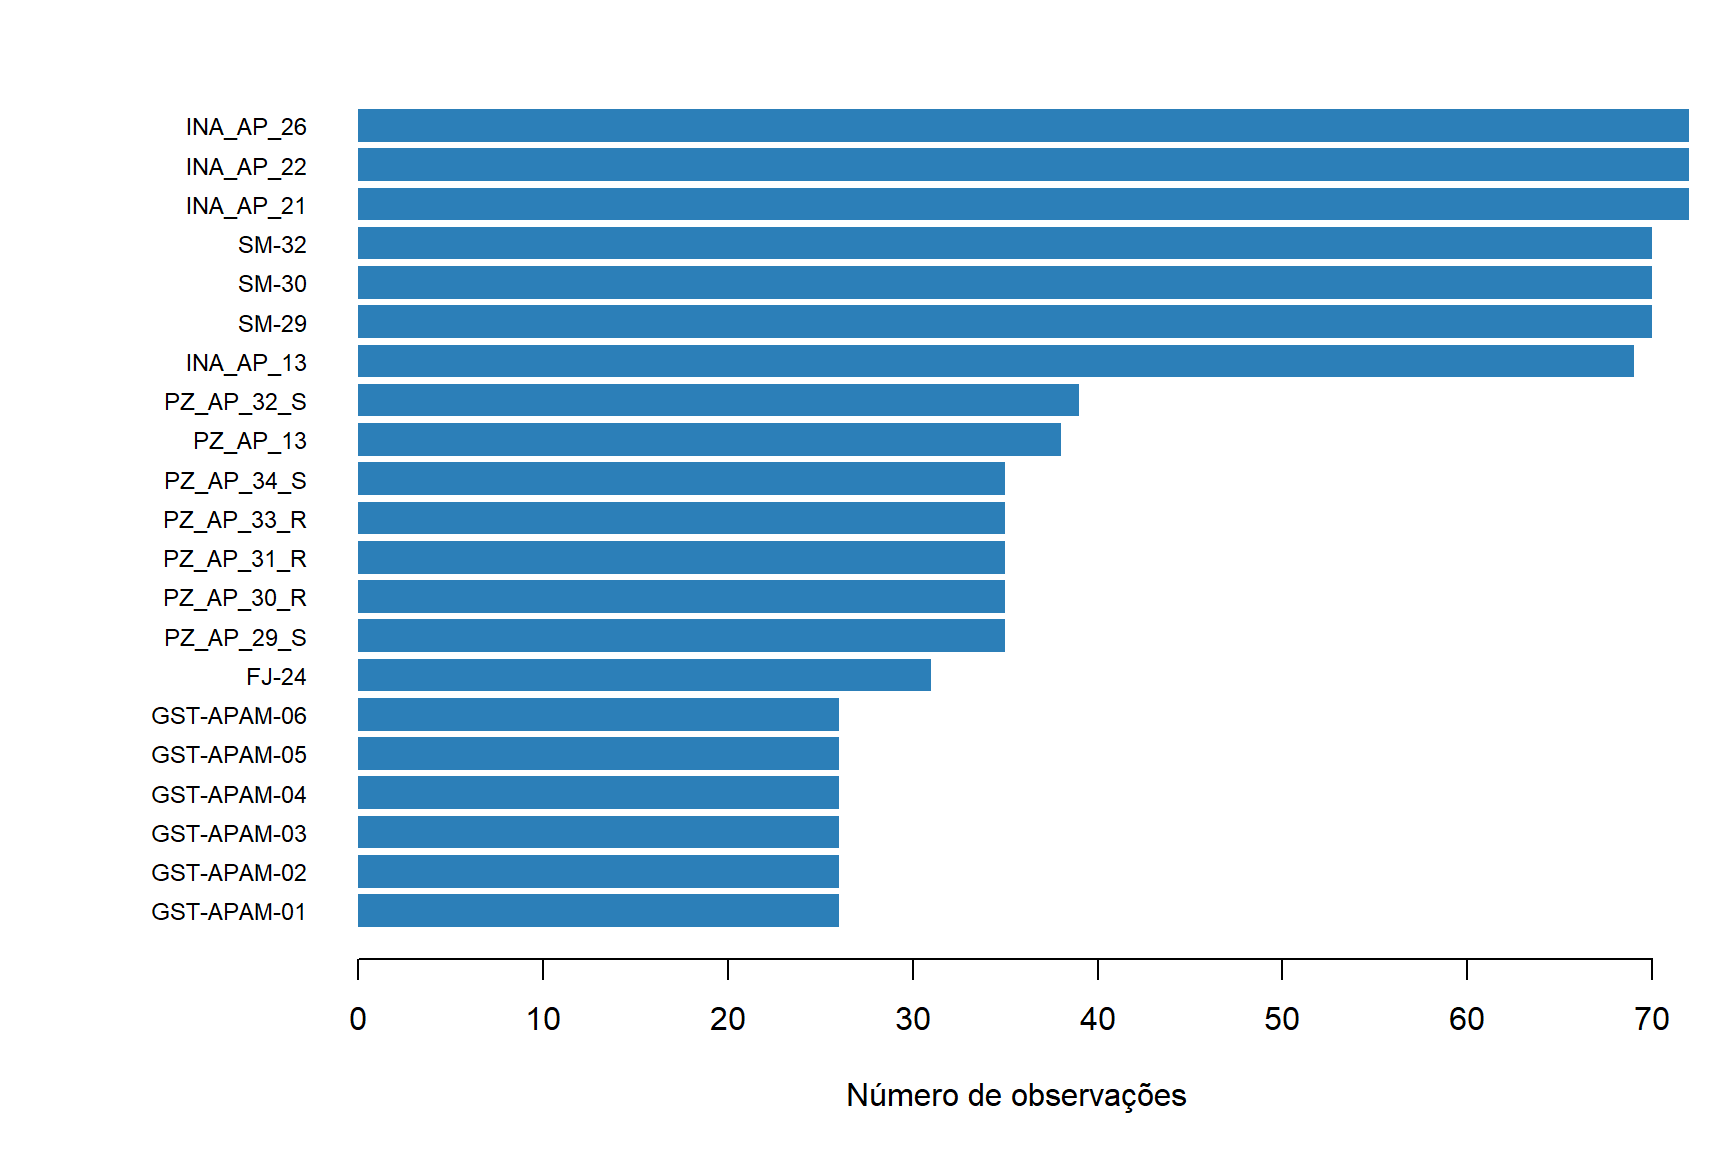
A quantidade de observações não é uniforme. Os instrumentos com mais registros possuem `r max(n_por_instrumento)` leituras válidas, enquanto aqueles com menor disponibilidade apresentam `r min(n_por_instrumento)`. Essa diferença impede uma comparação baseada apenas no número absoluto de ocorrências e reforça a necessidade de apresentar as estatísticas separadamente.
### Estatística descritiva
```{r}
#| label: tabela-estatistica
instrumentos <- sort(unique(dados_longos$instrumento))

resumo <- do.call(rbind, lapply(instrumentos, function(inst) {
  x <- dados_longos$cota[dados_longos$instrumento == inst]

  data.frame(
    Instrumento = inst,
    n = length(x),
    Média = mean(x),
    Mediana = median(x),
    Variância = var(x),
    `Desvio padrão` = sd(x),
    Mínimo = min(x),
    Máximo = max(x),
    Assimetria = coef_assimetria(x),
    Curtose = coef_curtose(x),
    Outliers = contar_outliers(x),
    check.names = FALSE
  )
}))

resumo_exibicao <- resumo
colunas_numericas <- c(
  "Média", "Mediana", "Variância", "Desvio padrão",
  "Mínimo", "Máximo", "Assimetria", "Curtose"
)
resumo_exibicao[colunas_numericas] <- lapply(
  resumo_exibicao[colunas_numericas], br_num
)

knitr::kable(
  resumo_exibicao,
  align = c("l", rep("r", ncol(resumo_exibicao) - 1)),
  caption = "Estatística descritiva das cotas de nível d'água por instrumento."
)
```
As cotas médias não devem ser comparadas diretamente como se todos os instrumentos estivessem instalados na mesma elevação. Cada instrumento possui uma referência altimétrica própria; por isso, a comparação mais adequada concentra-se na dispersão e na evolução de cada série.
Os menores desvios padrão foram observados nos instrumentos `r paste(resumo$Instrumento[order(resumo[["Desvio padrão"]])][1:3], collapse = ", ")`, indicando maior concentração das respectivas leituras em torno da média. Em sentido oposto, os maiores desvios padrão ocorreram em `r paste(resumo$Instrumento[order(resumo[["Desvio padrão"]], decreasing = TRUE)][1:3], collapse = ", ")`. A maior dispersão, contudo, não representa automaticamente uma condição anômala, pois pode decorrer de variações reais do nível d'água, alterações operacionais, diferenças no período de leitura ou inconsistências do banco.
O instrumento com maior assimetria positiva foi `r resumo$Instrumento[which.max(resumo$Assimetria)]`, com coeficiente igual a `r br_num(max(resumo$Assimetria))`. Esse resultado indica a presença de valores elevados em relação à maior concentração da série. A maior assimetria negativa ocorreu em `r resumo$Instrumento[which.min(resumo$Assimetria)]`, com coeficiente de `r br_num(min(resumo$Assimetria))`, o que caracteriza maior prolongamento para valores inferiores.
Quanto à curtose, `r sum(resumo$Curtose > 3, na.rm = TRUE)` das `r nrow(resumo)` séries apresentaram coeficiente superior a 3 e foram classificadas como leptocúrticas. Nessas séries, a maior concentração central é acompanhada por observações mais extremas. Os coeficientes devem ser interpretados com cautela, sobretudo para os instrumentos com menor número de registros.
### Distribuições de frequência
Para demonstrar a organização dos dados em classes, foi selecionado o instrumento com maior número de observações. A tabela é produzida com funções do R e representa o mesmo princípio de tabulação explorado pelo pacote `leem`. Quando o pacote está instalado, ele também é carregado para consulta e aplicação complementar.
```{r}
#| label: tabela-frequencia
if (requireNamespace("leem", quietly = TRUE)) {
  suppressPackageStartupMessages(library(leem))
}

instrumento_freq <- names(which.max(table(dados_longos$instrumento)))
x_freq <- dados_longos$cota[dados_longos$instrumento == instrumento_freq]
classes <- pretty(range(x_freq), n = 6)
faixas <- cut(x_freq, breaks = classes, include.lowest = TRUE, right = TRUE)
freq_abs <- table(faixas)

tabela_frequencia <- data.frame(
  Classe = names(freq_abs),
  `Frequência absoluta` = as.integer(freq_abs),
  `Frequência relativa (%)` = br_num(100 * as.integer(freq_abs) / length(x_freq)),
  check.names = FALSE
)

knitr::kable(
  tabela_frequencia,
  align = c("l", "r", "r"),
  caption = paste("Distribuição de frequência das cotas do instrumento", instrumento_freq)
)
```
A distribuição de frequência permite identificar os intervalos que concentram a maior parte das leituras do instrumento `r instrumento_freq`. Essa tabulação deve ser analisada junto ao gráfico temporal, pois uma mesma classe pode reunir observações registradas em períodos distintos.
### Evolução temporal
```{r}
#| label: evolucao-temporal
#| fig-cap: "Evolução temporal das cotas de nível d'água por instrumento."
#| fig-width: 10
#| fig-height: 12
grupos <- split(instrumentos, ceiling(seq_along(instrumentos) / 7))
par(mfrow = c(length(grupos), 1), mar = c(3, 4, 2, 1), oma = c(1, 0, 0, 0))
cores <- grDevices::hcl.colors(7, "Dark 3")

for (g in seq_along(grupos)) {
  inst_grupo <- grupos[[g]]
  dados_grupo <- dados_longos[dados_longos$instrumento %in% inst_grupo, ]
  limite_y <- range(dados_grupo$cota, na.rm = TRUE)

  plot(
    range(dados_grupo$data), limite_y,
    type = "n",
    xlab = "Data",
    ylab = "Cota (m)"
  )

  for (i in seq_along(inst_grupo)) {
    d <- dados_grupo[dados_grupo$instrumento == inst_grupo[i], ]
    lines(d$data, d$cota, type = "o", pch = 16, cex = 0.45, col = cores[i])
  }

  legend(
    "topright",
    legend = inst_grupo,
    col = cores[seq_along(inst_grupo)],
    lty = 1,
    pch = 16,
    cex = 0.62,
    bty = "n",
    ncol = 2
  )
}
```
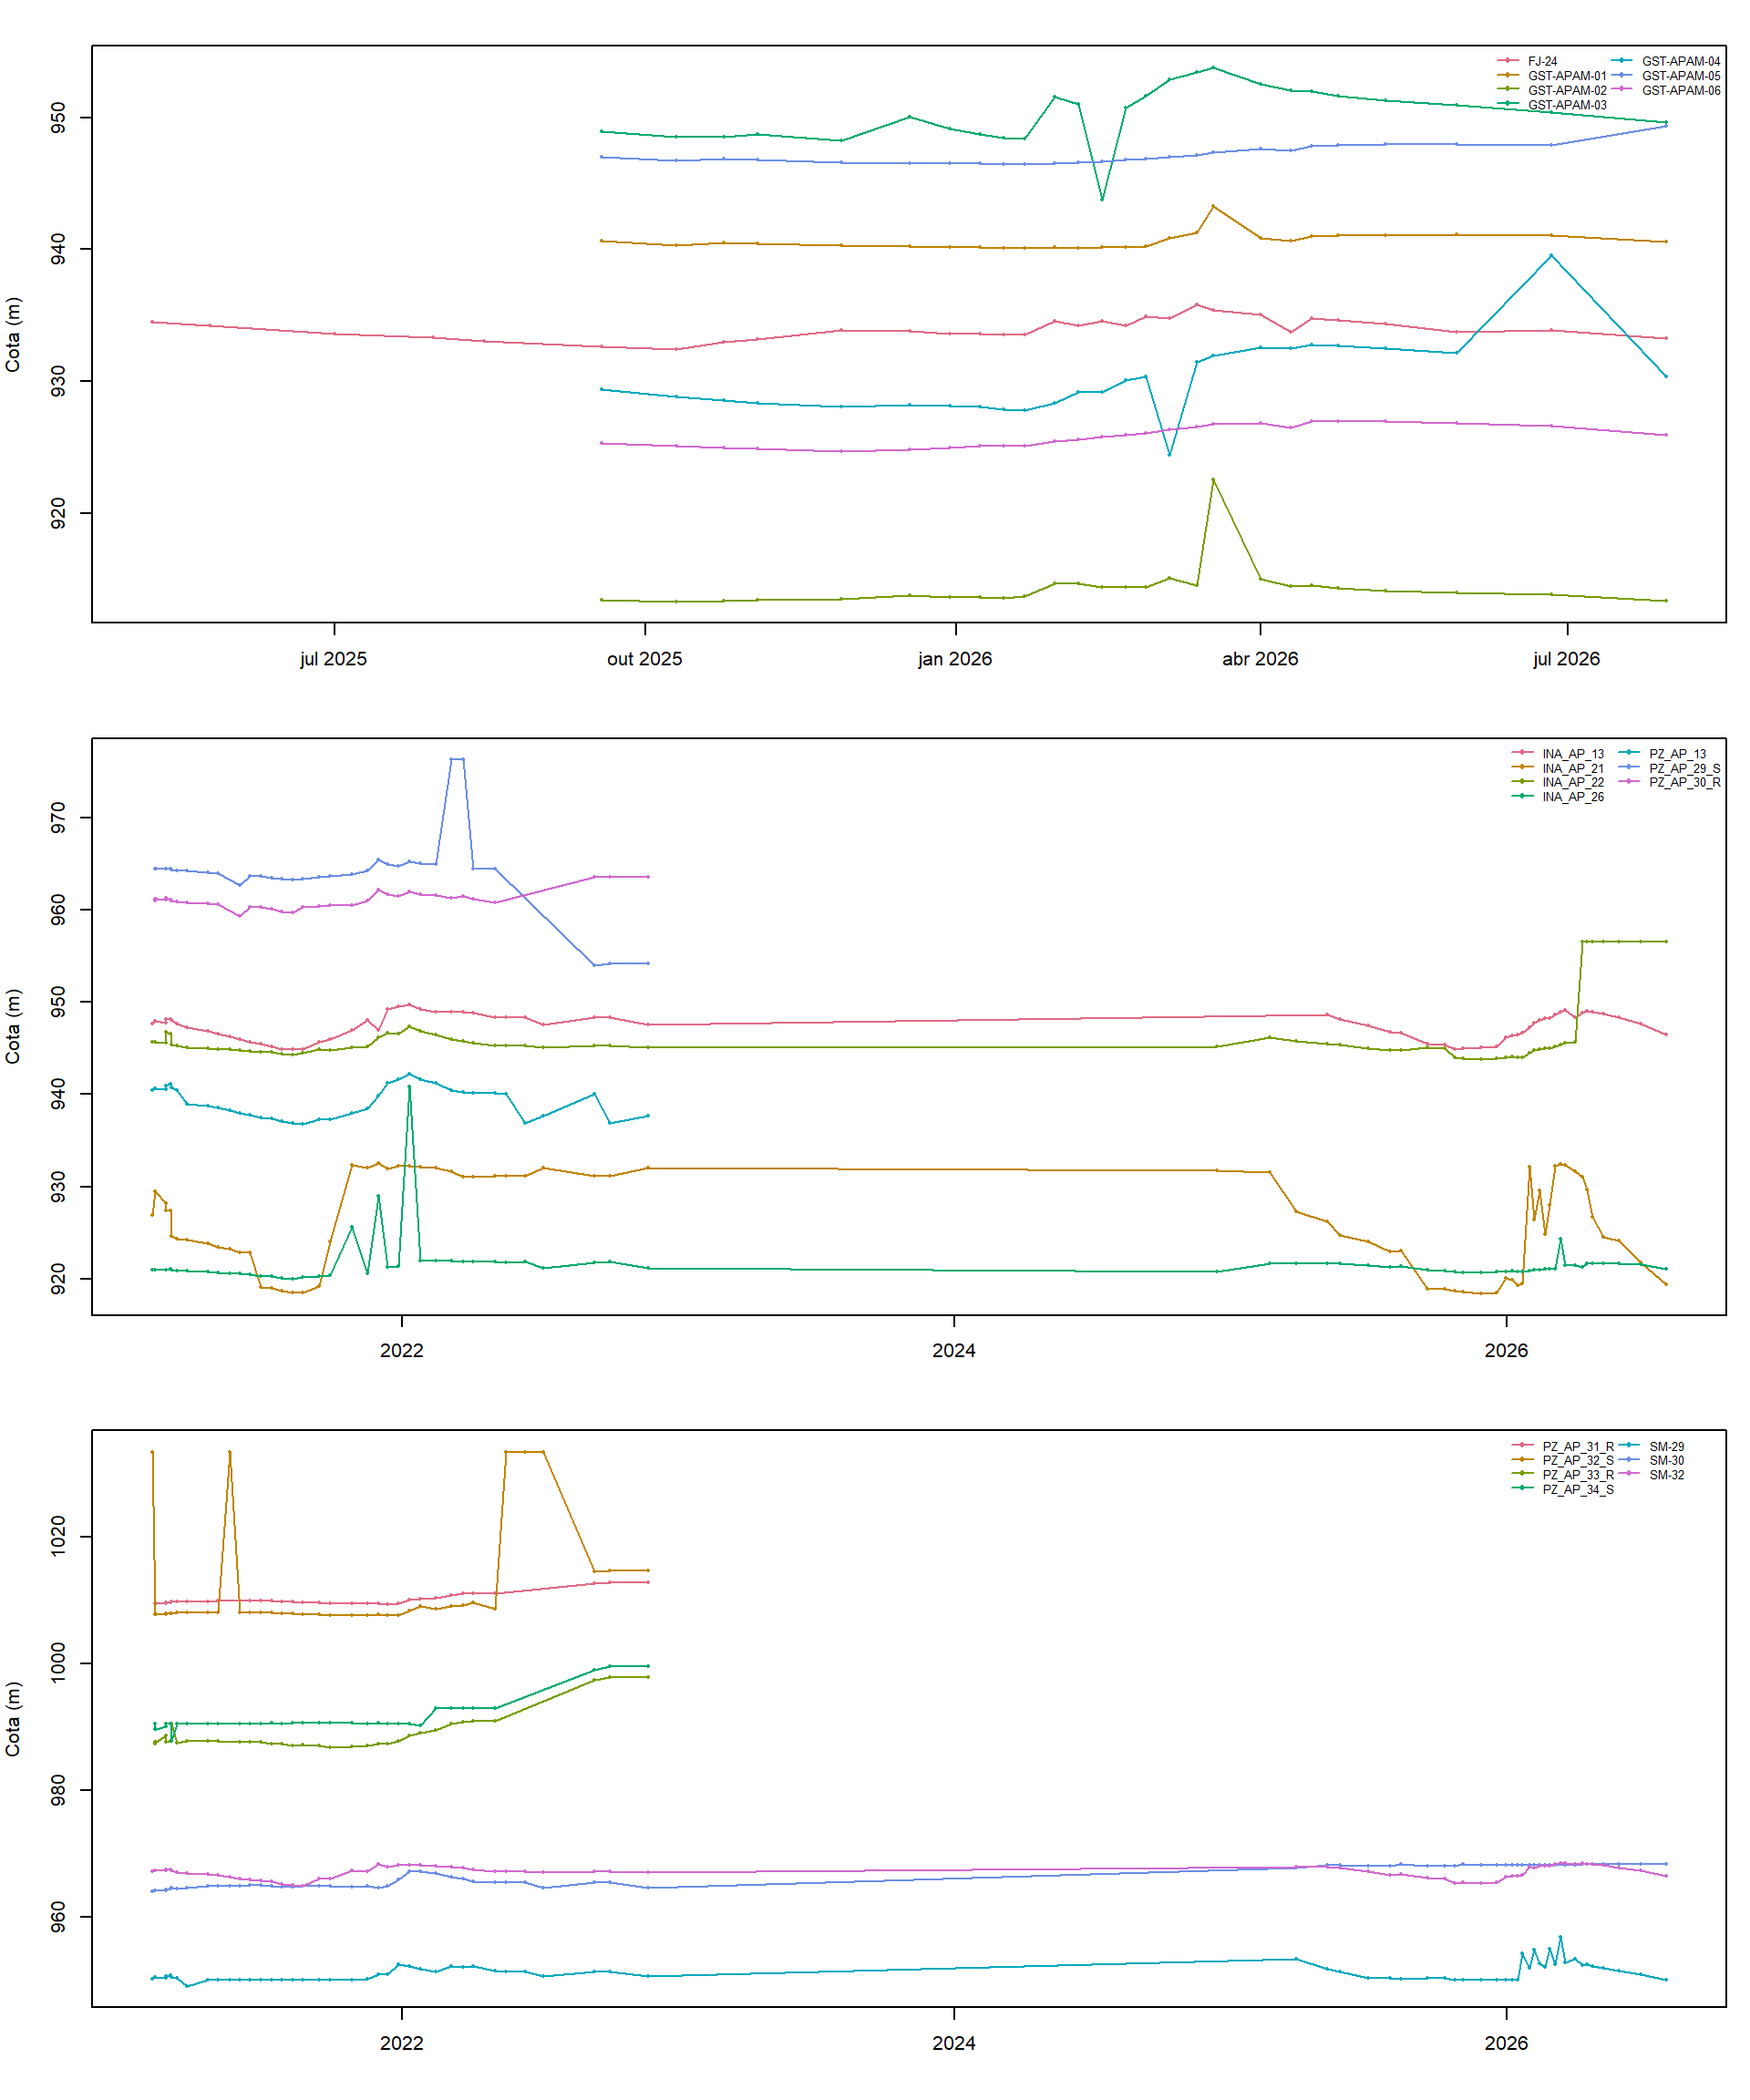
Os gráficos evidenciam que os instrumentos não possuem a mesma extensão temporal nem a mesma regularidade de leituras. Também são observados intervalos prolongados sem registros em parte das séries. Consequentemente, variações entre duas leituras consecutivas podem representar mudanças ocorridas ao longo de períodos distintos e não devem ser interpretadas somente pela inclinação visual dos segmentos.
Algumas séries apresentam mudanças de patamar e valores isolados, principalmente no início ou no fim do período monitorado. Esses comportamentos influenciam a média, o desvio padrão, a assimetria e a curtose. Antes de atribuir uma causa geotécnica, é necessário verificar as fichas dos instrumentos, eventuais alterações de referência, manutenções, condições operacionais e registros pluviométricos.
### Dispersão e possíveis valores discrepantes
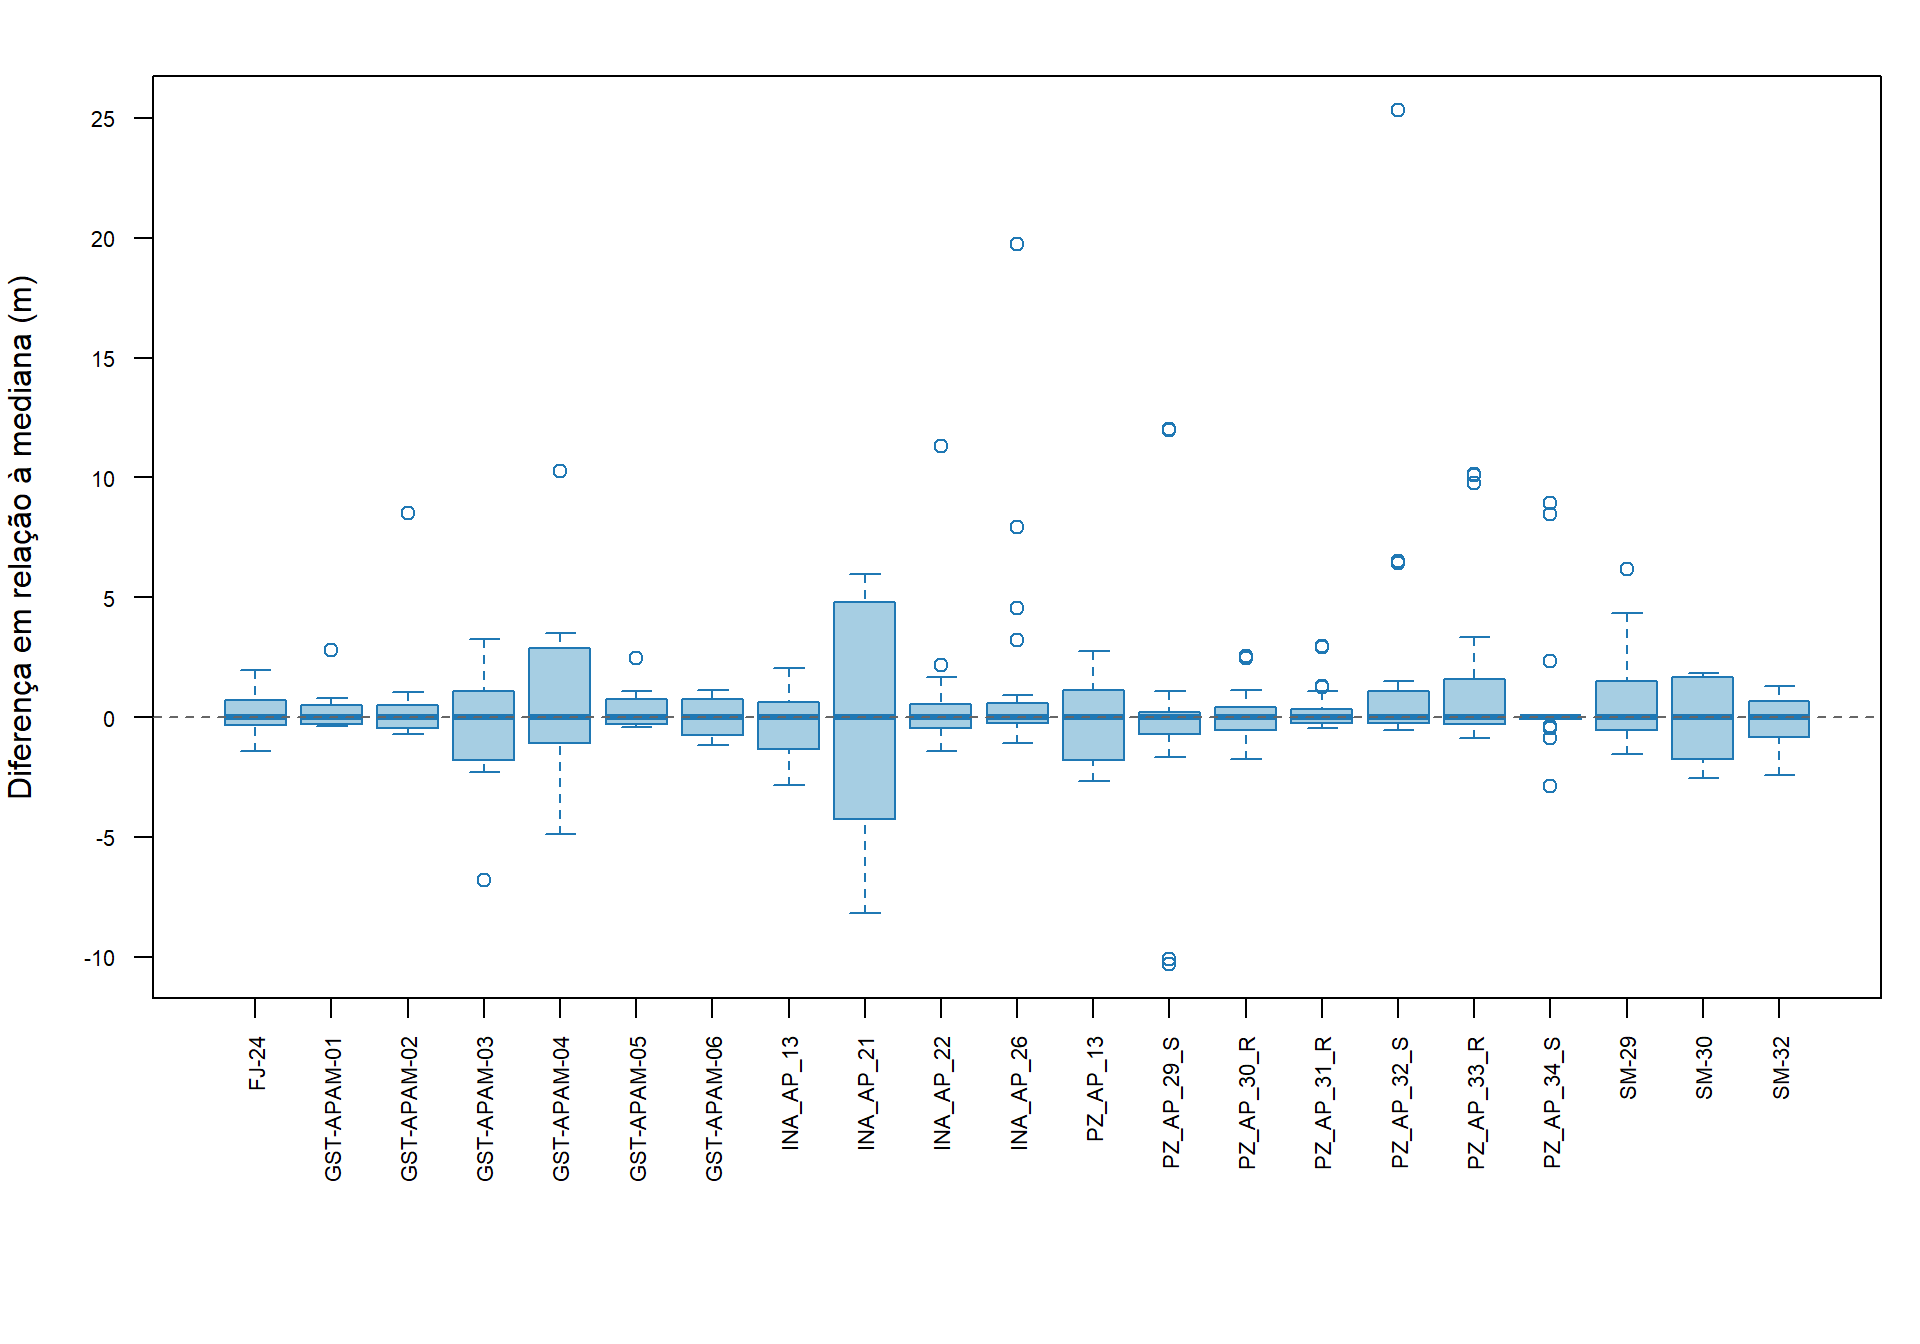
Para permitir a comparação visual entre instrumentos instalados em cotas distintas, cada leitura foi centralizada pela mediana de sua própria série.
```{r}
#| label: boxplot
#| fig-cap: "Distribuição das cotas centralizadas pela mediana de cada instrumento."
#| fig-width: 10
#| fig-height: 7
medianas <- tapply(dados_longos$cota, dados_longos$instrumento, median, na.rm = TRUE)
dados_longos$desvio_mediana <- dados_longos$cota - medianas[dados_longos$instrumento]

par(mar = c(9, 4, 2, 1))
boxplot(
  desvio_mediana ~ instrumento,
  data = dados_longos,
  las = 2,
  col = "#A6CEE3",
  border = "#1F78B4",
  outline = TRUE,
  ylab = "Diferença em relação à mediana (m)",
  xlab = "",
  cex.axis = 0.7
)
abline(h = 0, lty = 2, col = "gray40")
```
Pelo critério de 1,5 vez a amplitude interquartil, foram sinalizadas `r sum(resumo$Outliers)` observações potencialmente discrepantes, distribuídas em `r sum(resumo$Outliers > 0)` instrumentos. O `r resumo$Instrumento[which.max(resumo$Outliers)]` apresentou a maior quantidade de pontos sinalizados (`r max(resumo$Outliers)`). Entretanto, um *outlier* estatístico não deve ser automaticamente classificado como erro. No monitoramento geotécnico, o valor pode estar associado a uma alteração real, a uma mudança de referência, à recuperação do instrumento após período seco ou a uma falha de leitura ou digitação.
A elevada curtose observada em algumas séries é coerente com a presença desses valores afastados da região central. Da mesma forma, a diferença entre média e mediana em determinados instrumentos confirma o efeito das caudas assimétricas. Assim, a análise numérica e gráfica indica quais registros merecem verificação, mas não fornece, isoladamente, a causa das variações.
### Síntese da análise
De forma geral, os resultados mostram diferentes níveis de variabilidade entre os instrumentos. Parte das séries apresenta comportamento concentrado e relativamente estável, enquanto outras possuem mudanças de patamar, assimetria acentuada ou valores extremos. Essas diferenças podem estar relacionadas às condições hidrogeológicas locais, à precipitação, à drenagem, às intervenções na estrutura e ao próprio histórico de funcionamento dos instrumentos.
A principal limitação do banco está relacionada à ausência de leituras em diversos períodos, à quantidade desigual de observações e à existência de datas repetidas sem identificação de horário. Por esse motivo, os resultados devem ser utilizados como etapa inicial de triagem e organização do monitoramento.
------------------------------------------------------------------------
## 🧠 Considerações finais
O trabalho permitiu aplicar os fundamentos da linguagem R e da Estatística Descritiva a um banco real de monitoramento geotécnico. O objetivo proposto foi alcançado por meio da importação, do tratamento e da análise das cotas de nível d'água registradas pelos instrumentos da PDE Água Preta.
As medidas de posição, dispersão e forma mostraram que as séries apresentam comportamentos distintos. Enquanto alguns instrumentos possuem leituras concentradas em torno da média, outros apresentam maior variabilidade, assimetria, curtose elevada e possíveis valores discrepantes. Os gráficos temporais e os diagramas de caixa complementaram os resultados numéricos e permitiram identificar registros que necessitam de avaliação individual.
Também se verificou que valores extremos não devem ser excluídos automaticamente, pois podem representar tanto inconsistências quanto mudanças reais no comportamento hidrogeotécnico. A interpretação adequada depende da conferência do histórico dos instrumentos e da comparação com outros fatores diretos e indiretos, como precipitação, intervenções operacionais e demais informações de campo.
Como aprimoramento, recomenda-se padronizar a estrutura do banco, registrar horário e status de cada leitura, eliminar linhas auxiliares sem data e fazer as correlações necessárias aos agentes que influenciam os dados, sendo o principal dentre eles os registros pluviométricos. Essas medidas aumentariam a rastreabilidade e permitiriam uma avaliação mais completa do comportamento da estrutura.
## 📖 Referências
BATISTA, B. D. O.; OLIVEIRA, D. A. B. J. **R básico**. Ouro Branco, MG: [s.n.], 2022. (Estudando o Ambiente R, v. 1). Disponível em: <https://bendeivide.github.io/book-eambr01/>. Acesso em: 16 set. 2026.
R CORE TEAM. **R: A language and environment for statistical computing**. Vienna: R Foundation for Statistical Computing, 2026. Disponível em: <https://www.R-project.org/>. Acesso em: 16 set. 2026.